
Anima 教程:从第一张图到模型深处
整体结构 本教程共 14 章,外加三个附录,分四步走。前两章讲原理和定位,先画一张地图,用大白话讲清楚 AI 画图到底是怎么回事,再引出 Anima 是什么。第三到第六章是纯实操,装 ComfyUI、下模型、配工作流、出第一张图,全程手把手。第七、八章练生成技巧,讲参数怎么调、提示词怎么写,完成从「能出图」到「能出好图…
 Kusa_OlxY
整体结构
本教程共 14 章,外加三个附录,分四步走。前两章讲原理和定位,先画一张地图,用大白话讲清楚 AI 画图到底是怎么回事,再引出 Anima 是什么。第三到第六章是纯实操,装 ComfyUI、下模型、配工作流、出第一张图,全程手把手。第七、八章练生成技巧,讲参数怎么调、提示词怎么写,完成从「能出图」到「能出好图」的进阶。最后六章拆模型架构,逐层讲 Anima 是怎么实现的,再用一张大表和 SDXL 做个对照。附录放术语表、常见问题和资源链接,随手查。
第一部分:原理与定位(先看懂地图再出发)
第 1 章 AI 绘图极简原理(小白版)
本章目标:用不超过 2500 字、零数学公式、全类比的方式,让完全没接触过 AI 绘图的新手理解「扩散模型是怎么工作的」。不涉及任何具体模型,只讲通用框架。
1.1 一个类比:AI 是怎么「学会」画画的
一个美术生是怎么学会画画的?从小到大看成千上万幅作品,一遍遍临摹,画得不像就重来。临多了,慢慢摸出规律:眼睛该在脸的什么位置,光从左边打来阴影落在哪,什么笔触能画出毛发的质感。到最后不用参考图,也能凭经验画出全新的东西。AI 画图模型走的是同一条路。它「看」了几亿张图,记住的不是哪一张具体图片,而是像素排列的统计规律:什么样的像素组合像头发、像天空、像人的眼睛。给它一段文字,它就能按这些规律重新组合出一张新图。这里有个误解得先讲清楚:AI 不是从图库里剪一块拼上去,也不是在「抄袭」哪张已有的图,它输出的每一个像素都是现场算出来的。
1.2 扩散模型的两个阶段
Anima 这类扩散模型的工作方式,可以拆成两个完全相反的过程。训练阶段是一场「破坏与复原」的游戏:取一张清晰图,逐步往上加随机噪声,越加越多,直到整张图变成一片雪花点,完全看不出原来是什么;让 AI 反复看「从清晰到模糊」的每一步,它学到的就是逆向的规律,怎么把模糊重新变清晰。生成阶段反着来,从一张纯噪声图起步,此时它脑子里什么都没有,只靠输入的文字提示,一步步去掉噪声、还原出清晰画面。每步只去掉一小点噪声,就像从极度模糊慢慢对焦。整个过程可以想象成一段倒放视频:一张清晰照片先被打满马赛克,AI 再学着把马赛克一层层揭掉。
1.3 潜空间(Latent Space):为什么 AI 不在像素上画画
这里有个现实问题。如果直接在像素层面动手,一张 1024×1024 的图有 100 多万个像素点,按 RGB 三通道展开是 300 多万个数值,每一步加噪去噪都要在这 300 万个值上算,普通电脑扛不住。所以得「先压缩、再创作、最后解压」:先用一个压缩器(VAE 编码器)把图片压成小得多的特征图,加噪去噪都在这个压缩后的潜空间里完成,最后再用解压器(VAE 解码器)还原成高清图。拿 Anima 说,它的 VAE 在空间上把 1024×1024 压到 128×128,每边缩小 8 倍、面积缩小 64 倍,同时用 16 个通道装信息。这么一来,扩散模型真正要处理的潜空间表示只有 128×128×16,约 26 万个数值,比原来的 314 万像素少了大约 12 倍。就像剪一个特别大的视频,先压成小体积的代理文件,剪完再渲染回高清,VAE 干的就是压缩和解压这两件事。
1.4 提示词(Prompt)是怎么起作用的
提示词是文字,AI 处理的是数字,所以文字得先翻译。文本编码器(Text Encoder)把提示词变成一串数字向量,叫语义嵌入,也叫条件向量。去噪的每一步,这些向量会通过一种叫交叉注意力(Cross-Attention)的机制,告诉扩散模型下一步该往哪个方向去噪、画面里该出现什么。说白了,提示词就是递给 AI 的一张文字地图,它每走一步都掏出地图确认方向,免得跑偏,最后走到描述的目的地。
1.5 一句话总结整个流程
把上面四个环节串成一条流水线:
文字提示词 → 文本编码器 → 语义向量
随机噪声(潜空间) + 语义向量 → 扩散模型逐步去噪 → 去噪完成后的潜空间特征
潜空间特征 → VAE 解码器 → 最终高清图片
所有主流 AI 绘图模型都遵循这个框架,区别只在于每个环节用了什么具体技术。Anima 也不例外,下一章就把它对号入座。
1.6 这一章没有讲的东西
说实话,这一章是对真实过程的极度简化,数学公式、具体的网络结构、采样调度的细节、CFG 的计算方式,全都没讲。只想会上手,读到这里已经足够;想弄懂具体实现的,第四部分会用同样的大白话逐块拆开讲。
第 2 章 Anima 是什么——基于上述原理的具体模型
本章目标:承接第 1 章,把通用框架映射到 Anima 的具体组件上,让读者知道「Anima 就是按照这个框架做出来的模型」,形成整体认知。
2.1 模型家族与基本定位
Anima 是个文生图模型,输入文字,输出动漫、二次元风格的图片,由 circlestone-labs 和 Comfy Org 合作发布,权重放在 Hugging Face(circlestone-labs/Anima)。DiT 主干有 20 层、28 层、36 层三种规格,官方主推的 2B 版是 28 层、约 2.1B 参数,技术基座是 NVIDIA Cosmos-Predict2 的 Text2Image 架构加 Rectified Flow 生成框架。官方按用途还发了三个版本:Base 是预训练底模,Aesthetic 是质量微调版,Turbo 是蒸馏加速版、CFG 1 加 8–12 步就能出图,新手建议从 Turbo 上手。
2.2 通用框架 → Anima 组件的映射表
把第 1 章的通用概念和 Anima 的具体实现一一对上:
| 通用概念 | Anima 的具体组件 |
|---|---|
| 文本编码器(把文字翻译成向量) | Qwen3-0.6B(基于现代大语言模型的编码器,支持 512 token 长上下文) |
| 文本适配桥接(可选) | LLM Adapter(6 层 Transformer,把 Qwen3 的语义空间映射到扩散模型能理解的空间) |
| 潜空间压缩器(VAE 编码器) | Qwen-Image VAE(16 通道输出,空间 8× 压缩) |
| 潜空间解压器(VAE 解码器) | Qwen-Image VAE(与编码器对称) |
| 扩散去噪主干(在潜空间操作的核心网络) | DiT(Diffusion Transformer),28 层 Transformer,2048 维隐藏状态,16 个注意力头 |
| 去噪方式 / 训练目标 | Rectified Flow(流匹配),采用速度场预测(v-prediction),而非传统 DDPM 的噪声预测(ε-prediction) |
| 采样调度器 | FlowMatchEulerDiscreteScheduler,连续时间 [0, 1] 区间,推荐步数 30–50 |
2.3 Anima 的「身份档案」
- 全名:Anima Base v1.0
- 主干架构:DiT(纯 Transformer,取代 U-Net)
- 参数量:约 2.09B(DiT 主干,官方口径 2B)+ 0.6B(Qwen3,冻结)+ 约 0.13B(VAE),三个文件合计约 2.8B
- 文本编码器:Qwen3-0.6B(冻结)+ LLM Adapter(可训练)
- 潜在空间:16 通道,8× 空间压缩(输入 1024² 图片 → 潜在尺寸 128²)
- 生成框架:Rectified Flow(流匹配,连续时间)
- 推荐采样参数:30–50 步,CFG 4–5,Euler / dpmpp_2m_sde_gpu
- 分辨率范围:512²–1536²(原生 1024²,靠 RoPE 外推覆盖)
2.4 为什么 Anima 值得尝试
Anima 的自然语言理解能力明显更强。Qwen3 是正经的大语言模型,512 token 上下文能准确读懂复杂长提示词,把 SDXL 的 CLIP(77 token×2)甩开一大截。它在低 CFG 下也很稳,Rectified Flow 框架下 CFG 只要 4–5,远低于 SDXL 的 7–9,出图不容易过饱和。少步数也能用,Euler 采样器跑 30 步就有高质量输出,不用依赖高阶采样器。它还能把分辨率往外推,1536² 直接就能跑。
第二部分:从零跑通 Anima(零基础实操)
本部分目标:让完全没接触过 ComfyUI 的读者,在 30–40 分钟内完成安装、下载、配置并生成第一张 Anima 图。不讲原理,只教操作。
第 3 章 准备工作:安装 ComfyUI
章节说明:ComfyUI 是运行 Anima 最可靠、官方最推荐的图形界面。本章教读者从零安装。
3.1 ComfyUI 是什么
ComfyUI 是一个节点式的 AI 绘画软件,通过连接一个个功能模块(节点)来搭建生成工作流。选它是因为 Anima 官方原生支持,社区工作流最丰富,显存优化也最好。
3.2 电脑配置要求
- 最低配置(能跑,较慢):NVIDIA GTX 1060 6GB / RTX 2060 6GB,16GB 内存。
- 推荐配置(流畅):NVIDIA RTX 3060 12GB / RTX 4060 Ti 16GB 或更高,32GB 内存。
- 操作系统:Windows 10/11(首选),macOS(Apple Silicon,性能较弱),Linux。
- 特别说明:目前 Anima 主要针对 NVIDIA 显卡(CUDA)优化,AMD 显卡用户可能需要额外配置。
3.3 下载 ComfyUI
官方 GitHub 仓库地址是 https://github.com/comfyanonymous/ComfyUI。Windows 用户推荐下载 ComfyUI_windows_portable_nvidia.7z(NVIDIA 显卡首选,自带 Python 环境和依赖,解压即用;AMD / Intel 显卡选对应的 amd / intel 版本)。Mac、Linux 用户在仓库页面找对应的安装说明。不建议从非官方来源下载,安全第一。
3.4 解压与目录结构说明
下载后解压到任意位置,路径最好别带中文和空格,比如 D:\ComfyUI。解压完,目录里几个文件夹的用途如下:
| 文件夹 | 用途 |
|---|---|
| models/ | 存放所有模型文件(DiT、VAE、文本编码器、LoRA 等) |
| custom_nodes/ | 存放第三方扩展插件 |
| output/ | 生成的图片默认保存位置 |
| input/ | 输入图片(如用于图生图)存放位置 |
3.5 第一次启动与界面认识
Windows 下双击 run_nvidia_gpu.bat 启动(NVIDIA 显卡),没独显就用 run_cpu.bat。启动时命令行窗口会弹出、滚动刷日志,这很正常,先不要关。当末尾出现 http://127.0.0.1:8188 就说明启动成功了。打开浏览器,地址栏输入这个地址回车,看到界面就算成。
3.6 常见启动报错及解决方法
- 报错
CUDA is not available:显卡驱动没装或版本太低,去 NVIDIA 官网更新驱动。 - 报错
Out of memory:显存不够,启动参数加--lowvram或--novram试试。 - 报错
No module named 'torch':Python 环境依赖缺失,重新解压便携版或运行install.py。 - 其他冷门错误:去 Hugging Face 模型页的 Community 区,或 CivitAI、TensorArt 这类社区的讨论区搜解决方案。
第 4 章 下载 Anima 的三个核心模型文件
章节说明:Anima 不是单个文件就能跑,它需要三个独立组件协同工作。本章让读者清楚知道「需要下载什么」「放在哪里」。
4.1 三个文件清单与分工
| # | 文件 | 作用 | 大小预估 |
|---|---|---|---|
| 1 | DiT 主干(anima-base-v1.0.safetensors) | 负责核心的去噪生成过程,是最大的文件 | 约 4.2 GB |
| 2 | 文本编码器(qwen_3_06b_base.safetensors) | 把提示词翻译成 AI 能理解的语义向量 | 约 1.2 GB |
| 3 | VAE(qwen_image_vae.safetensors) | 潜空间与像素空间之间的压缩与解压 | 约 0.25 GB |
4.2 Hugging Face 下载指引
官方仓库地址是 https://huggingface.co/circlestone-labs/Anima。打开页面点 Files 标签,在文件列表里找到上面三个 .safetensors,逐个点右边的下载按钮(↓)。网慢的话可以用 Hugging Face 镜像站,或者 huggingface_hub 命令行。注意别下无关文件(.gitattributes、README.md 这些),只下三个 .safetensors。
4.3 文件放置路径(完整路径 + 截图示例)
以解压后的 ComfyUI 根目录为 ComfyUI/,三个文件分别放到:
ComfyUI/models/diffusion_models/anima-base-v1.0.safetensors
ComfyUI/models/text_encoders/qwen_3_06b_base.safetensors
ComfyUI/models/vae/qwen_image_vae.safetensors
models/ 下如果没有 diffusion_models/ 或 text_encoders/ 文件夹,手动建一个就行。
4.4 如何确认放置正确
重启 ComfyUI(关掉命令行窗口再双击 .bat),在启动日志里搜文件名。看到 Loading diffusion model: anima-base-v1.0.safetensors 且没报错,就对了。要是出现 File not found 或 No such file,查一下路径是不是写错、文件名有没有多余后缀。
第 5 章 获取与加载 Anima 工作流
章节说明:有了模型文件,还得有个「工作流」告诉 ComfyUI 怎么把这些文件连起来。本章教读者获取官方工作流并加载。
5.1 工作流是什么(通俗类比)
工作流是个 .json 文件,记录了所有节点的位置、连线和参数。模型文件是食材,工作流是菜谱,没有菜谱,食材堆那儿也不知道怎么做。ComfyUI 有个贴心功能:能把工作流直接嵌进生成的图片里,所以把别人生成的图拖进来,对应的完整工作流就会自动加载。
5.2 获取官方工作流的三种途径
- 途径一(最推荐):在 Hugging Face 仓库的
README.md页面里找到官方示例图,直接拖进 ComfyUI 界面即可导入工作流。 - 途径二:通过 ComfyUI Manager(需提前装 Manager 插件),在「模板」或「工作流」里搜 "Anima",点官方模板加载。
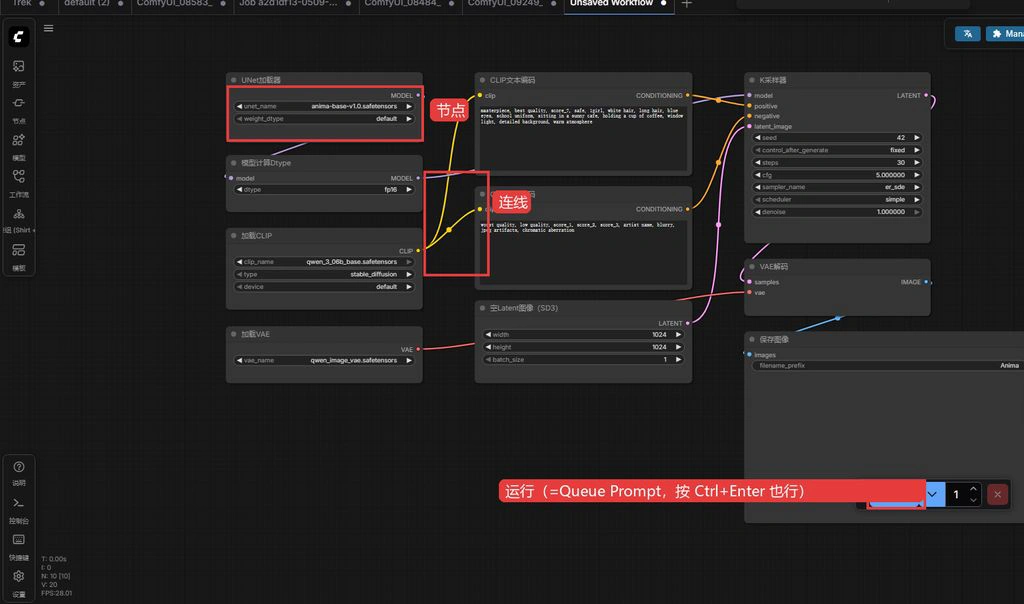
- 途径三:手动搭建,不推荐新手,可以照截图「看着搭」,但前两种方式简单得多。
5.3 导入工作流并检查节点
以「拖图片导入」为例:打开 ComfyUI,把官方示例图拖到工作区松手,工作流自动弹出。然后检查三个模型节点指向的文件对不对:「Load Diffusion Model」应显示 anima-base-v1.0.safetensors,「Load Text Encoder」应显示 qwen_3_06b_base.safetensors,「Load VAE」应显示 qwen_image_vae.safetensors。不对的话,点节点上的文件选择框重选。
第 6 章 输入提示词,生成第一张图
章节说明:万事俱备,本章让读者真正按下生成按钮,看到自己的第一张 Anima 作品,这是整个教程里最有成就感的一步。
6.1 输入正向提示词(可直接复制)
在工作流里找到「CLIP Text Encode (Prompt)」节点(正向提示词节点),文本框里输入下面这段,直接复制即可:
masterpiece, best quality, score_7, safe, 1girl, white hair, long hair, blue eyes, school uniform, sitting in a sunny cafe, holding a cup of coffee, window light, detailed background, warm atmosphere
这段的大意是:一个白头发、蓝眼睛的女学生坐在咖啡厅里。不用逐词翻译,知道这是「一个人物加场景的描述」就行。
6.2 输入负向提示词(可直接复制)
找到「CLIP Text Encode (Prompt)」节点里带 negative 标识的那个(负向提示词节点),输入:
worst quality, low quality, score_1, score_2, score_3, artist name, blurry, jpeg artifacts, chromatic aberration
负向提示词的作用是告诉 AI 要排除什么,比如低画质、低分、模糊、JPEG 伪影、色差这些。
6.3 检查生成参数
- 「Empty Latent Image」节点(或类似采样参数节点):分辨率(Width / Height)设
1024 x 1024,批大小(Batch Size)设1(一次只出一张)。 - 采样器节点(通常叫「KSampler」或「SamplerCustom」):步数(Steps)
30、CFG(CFG Scale)5.0、采样器(Sampler)euler、调度器(Scheduler)normal或simple。 - 这些参数此处不必深究,照着设置即可,第七章会逐条解释。
6.4 点击生成与等待
点界面右侧的「Queue Prompt」(或按 Ctrl+Enter),盯着命令行窗口的进度条,等 10–30 秒(看显卡性能)。出图后,图片会出现在工作区的输出节点里,右键能存到本地,ComfyUI/output/ 文件夹里也能找到。到这一步,第一张 Anima 图就完成了。
6.5 报错排查清单
- 报错「Checkpoint file not found」:模型路径不对,回看第四章,确认文件放在
models/diffusion_models/下。 - 报错「CUDA out of memory」:显存不够,降到 768×768 或 512×512,或启动加
--lowvram。 - 报错「Node type not found」:缺自定义节点,去 ComfyUI Manager 装对应节点。
- 报错「VAE decode failed」:VAE 文件不匹配或损坏,重新下
qwen_image_vae.safetensors覆盖。 - 生成结果全黑或全灰:多半是 VAE 加载失败,查 VAE 节点连没连对。
第三部分:掌握生成技巧(实战向)
本部分目标:读者已经能出图,但可能「随机性很强,不知道怎么控制」。本部分通过对比图讲清每个参数的作用,并教会读者用提示词精准控制画面。
第 7 章 生成参数逐一拆解(配对比图)
章节说明:本章每一节都配并排对比图(同一种子、只变一个量),让读者直观看到参数对画面的影响。
7.1 分辨率(Width / Height)
分辨率就是输出图片的长宽像素数。Anima 官方支持 512² 到 1536²,原生训练分辨率是 1024×1024,建议以它为基准:512×512 会糊、丢细节,768×768 能用但偏软,1024×1024 是甜点位,1536×1536 细节最足但吃显存。显存和分辨率是平方关系,分辨率翻一倍,像素数翻四倍。长宽比可以改,比如 1024×1536 这种竖图,但 H 和 W 都得能被 16 整除,这是 Anima 的结构约束(VAE 空间 8× 下采样,DiT 再按 2×2 切 patch,合起来 8×2=16)。
7.2 采样步数(Steps)
采样步数就是去噪迭代的次数,每步去掉一点噪声。同一提示词在不同步数下差别挺明显:10 步画面糊、结构不全;20 步基本成形但细节糙;30 步清晰锐利、细节足,是推荐起步值;50 步提升有限,边际收益递减。所以 30–50 步最划算,超过 80 步肉眼基本看不出差别,纯属多等。
7.3 提示词引导强度(CFG Scale)
CFG 控制模型「听提示词的程度」。数值越高,画面越贴提示词,但容易过饱和、颜色失真;越低,模型越自由,可能跑偏。同一提示词在不同 CFG 下:1.0 基本不理提示词,画面随机;3.0 大致照着来但偏平淡;5.0 是平衡点,画质和相关性都好(Anima 推荐值);7.0 颜色加深、对比增强,可能轻微过饱和;10.0 颜色过猛,可能出伪影或画风突变。这里要特别提醒一句:Anima 推荐 CFG 是 4–5,比 SDXL 的 7–9 低不少,这是 Rectified Flow 框架的特性,照搬 SDXL 的调参习惯会把颜色推过头。
7.4 采样器(Sampler)
采样器决定去噪的「行走路径」,不同采样器在步数和质量之间做不同取舍。不用全列,Anima 上几个常用的:er_sde 是作者自己推荐的默认,风格中性、色块平、线条利落;euler 稍多点创意,配 Turbo、Aesthetic 这种本来就稳的版本不错;euler_a(Euler Ancestral)带随机性,画面更有灵气,但同一种子每次结果略有不同;dpmpp_2m_sde_gpu 收敛快、质量高。具体选哪个,对比 30 步下的出图即可。
7.5 随机种子(Seed)
随机种子决定初始噪声图的「随机序列号」。同一种子加完全相同的参数,出的图就完全一致,可复现。固定种子的用处在于:调出一个不错的构图后,想微调提示词或参数时,锁住种子就能控制变量、方便对比。随机种子(-1)则每次都从不同噪声起步,结果各不相同。演示时用同一提示词、同一参数、不同种子(1、2、3)各出一张,能明显看出构图和细节的差异。
7.6 扩展:LoRA 插件的加载与使用
LoRA 一句话说是个轻量的「附加模块」,能给底模加画风、角色或概念,不用重训整个大模型。用法也简单:把 .safetensors 格式的 LoRA 放进 ComfyUI/models/loras/,工作流里加一个「Load LoRA」节点,接到扩散模型和采样器之间,再调 LoRA 权重(一般 0.6–1.2,太大画面会崩)。本章只讲怎么用现成的 LoRA,不涉及训练方法。
第 8 章 提示词体系 —— Anima 的「语言」
章节说明:Anima 的训练数据融合了 Danbooru 风格标签和自然语言描述,所以提示词既有标签的规则,又有句子的灵活。本章系统讲这两种写法。
8.1 Anima 训练数据的构成
简单交代下背景:Anima 的训练集里有几百万张动漫图和约 80 万张非动漫艺术图,动漫知识截止到 2025 年 9 月。每张动漫图都配了 Danbooru 社区风格的标签(如 1girl、blue_hair)和人工写的自然语言描述,所以它既听得懂标签,也听得懂句子,还能混着用。另外还混了两个非动漫数据集 LAION-POP 和 DeviantArt,用「数据集标签」区分。
8.2 标签写法规范
标签用小写英文字母,之间用英文逗号加空格隔开(, );多词标签用空格不用下划线,比如 school uniform 而不是 school_uniform,唯一的例外是 score 标签(score_9 这类)用下划线。示例:1girl, white hair, blue eyes, school uniform, sitting, coffee shop。顺序上官方建议按「质量/元信息 → 主体(1girl 等)→ 角色 → 系列 → 画师 → 通用标签」的大致顺序排,段内顺序随意。
8.3 质量标签体系
Anima 的训练数据里有两套质量评价,写的时候可以二选一,也可以混用。人工评级标签从高到低:masterpiece(杰作)、best quality(最佳质量)、good quality(良好质量)、normal quality(普通质量)、low quality(低质量)、worst quality(最差质量)。PonyV7 美学模型评分标签从高到低:score_9、score_8、score_7……score_1。官方推荐的正向前缀是 masterpiece, best quality, score_7, safe(实际使用时结尾带上英文逗号再接其他标签),负向开头写 worst quality, low quality, score_1, score_2, score_3。正负向都写质量标签,是因为一个告诉模型要什么质量,一个告诉它排除什么质量,两头一夹更稳。
8.4 画师标签(风格指定)
Anima 支持用特定格式调用训练数据里出现过的画师风格:提示词里加 @画师名,比如 @wanwan。注意这个 @ 必须加,不加效果会弱很多;加权重 (@wanwan:1.2) 则增强这个画风的影响。画师标签灵不灵,取决于训练数据里该画师的作品多不多,不是每个名字都有效。
画师名可以是带空格的多个词,官方模型卡的示例提示词里就有 @nnn yryr 这样的实际用例。想验证某个画师标签灵不灵,最快的办法是锁住种子,分别生成「带 @画师名」和「不带」的两张图对比。另外画师标签的位置很自由,放在自然语言描述的开头也有效,比如 masterpiece, best quality, @画师名. An anime girl with...。如果想要的画风在画师标签里实在找不到,还有个退路:去 CivitAI 等社区找现成的 Anima 风格 LoRA,官方就给过一个附带数据集和训练配置的风格 LoRA 示例(https://civitai.com/models/2536147),照着它也能自己训一个。
8.5 自然语言描述写法
除了标签,Anima 也听得懂完整英文句子,建议正向提示词里至少放 2–3 句完整描述。推荐的写法是按从全局到局部的顺序分层:先写全局质量标签,再写主体(角色是谁、长什么样、穿什么、在干什么),接着写环境和细节(什么场景、背景有什么、光线如何),最后写氛围情绪(温暖、清冷、梦幻还是紧张)。套用第六章的提示词,扩成句子就是这样:
masterpiece, best quality, score_7, safe, 1girl, white hair, blue eyes, school uniform, sitting at a wooden table in a cozy cafe, holding a cup of latte, afternoon sunlight streaming through the window, warm and relaxing atmosphere
同一个主题,可以对比纯标签、纯句子、混着写三种写法的出图差异。
8.6 权重语法
想强调或弱化某个元素,可以用权重语法 (关键词:权重):大于 1 是增强,小于 1 是减弱。比如 (white hair:1.3) 逼模型出白发,(coffee:0.8) 让咖啡别太抢眼。有一点要注意,Anima 对权重的敏感度比 SDXL 低,得给更大的值才到同等效果,官方示例甚至用 (chibi:2),所以权重可以放心往大试,不必照 SDXL 的习惯停在 1.5。
8.7 实战:从平庸到精彩的提示词演变
拿「一个女孩在花园里」这个主题,看提示词怎么一步步进化:
- 版本 1(极简):
a girl in a garden→ 画面空泛,缺细节,质量一般。 - 版本 2(加质量标签):
masterpiece, best quality, score_7, safe, a girl in a garden→ 画质提升,但内容还是笼统。 - 版本 3(加具体描述):
masterpiece, best quality, 1girl, white dress, long brown hair, standing in a rose garden, holding a bouquet, soft sunlight, pink flowers→ 画面具体化,元素丰富。 - 版本 4(加氛围和权重):
masterpiece, best quality, 1girl, white dress, long brown hair, standing in a rose garden, holding a bouquet, (sunlight:1.2), pink flowers, soft bokeh background, dreamy atmosphere→ 最终版画面精致、氛围到位。
每步配一张对应生成图,一眼就能看出「提示词越具体,画面越好」。
8.8 其他标签:时间、安全与数据集
除了质量和画师,Anima 还认几类标签。时间标签:具体年份用 year 2025、year 2024 这种,也可以按画风新旧用 newest、recent、mid、early、old。安全标签:safe、sensitive、nsfw、explicit,用来控制内容尺度,官方推荐的正向前缀里就带了 safe,想避免意外内容就把它加进正向。数据集标签:模型额外用 LAION-POP 和 DeviantArt 两个非动漫数据集训练过,这类数据的描述开头会带一个数据集标签(ye-pop 或 deviantart)加换行,普通用户一般用不到,知道有这么回事就行。
第四部分:模型架构深度拆解(从「怎么用」到「为什么」)
本部分目标:面向想深入理解 Anima 原理的读者,用通俗但严谨的语言逐模块拆解。术语首次出现都给「人话」解释,不堆公式,但技术细节保持准确。
第 9 章 一张图看懂 Anima 系统架构
章节说明:以一张完整数据流图为核心,让读者先看到全景,后续章节再逐块深入。
9.1 完整数据流图
从「输入提示词」到「输出图片」的完整流程,标出所有关键模块和数据形状:
用户提示词(文字)
  → Qwen3 分词器 + T5 分词器(双路输入)
  → Qwen3-0.6B 文本编码器(输出语义向量 512×1024)
  → LLM Adapter(6层Transformer桥,融合T5骨架,输出 crossattn_emb 512×1024)
  → 随机噪声(潜空间 16×128×128)+ 噪声时间步 t
  → DiT 主干(28层Transformer,逐层注入crossattn_emb,预测速度场 v)
  → 多次迭代去噪(Rectified Flow 采样器)
  → VAE 解码器(把 16×128×128 解压回 3×1024×1024 RGB图片)
  → 最终生成的图片
流程图里用不同颜色标出「训练时固定的部分」(如 Qwen3)和「推理时动态变化的部分」(如噪声)。
9.2 五大核心模块职责一览
| 模块 | 一句话职责 |
|---|---|
| Qwen3-0.6B 文本编码器 | 把文字提示词翻译成语义向量(冻结,不参与训练) |
| LLM Adapter | 把 Qwen3 的语义「桥接」到扩散模型能兼容的空间(6层Transformer) |
| DiT 主干 | 核心生成网络,在潜空间完成去噪(28层,约2.1B参数) |
| VAE | 压缩/解压图像,让扩散模型在低维空间高效操作(16通道,8×压缩) |
| Rectified Flow 采样器 | 控制去噪路径和步长,决定最终输出质量 |
第 10 章 文本侧 —— Qwen3-0.6B 与 LLM Adapter
章节说明:详细拆解「提示词是怎么被模型理解的」这条上游链路。
10.1 为什么用 Qwen3 代替 CLIP
SDXL 这类传统模型用 CLIP 做文本编码器,上下文窗口只有 77 个 token,也就是大概只能看 77 个英文单词,长提示词会被截断,信息丢得厉害。Anima 改用 Qwen3-0.6B,一个真正的现代大语言模型,上下文窗口 512 token,能完整读复杂的、结构化的长句。差别在哪?写「一个穿白连衣裙、戴红围巾、站在花园里、手拿一束粉玫瑰、阳光从树叶间洒下来的女孩」,CLIP 可能只抓到「女孩」「花园」「玫瑰」,Qwen3 能理清所有细节之间的关系。
10.2 「冻结」文本编码器的含义
Anima 训练时,Qwen3-0.6B 的参数是冻结的,也就是训练过程不更新它的权重。原因是 Qwen3 早在大规模文本语料上预训练好了,语义理解够强,冻结它既省训练显存,又防止模型把学到的语言知识「忘掉」。所以实际训练只更新 DiT 主干和 LLM Adapter 的少量参数。
10.3 LLM Adapter 的设计动机与工作原理
先说动机。Anima 的基础架构 Cosmos-Predict2 当初是为 T5 文本编码器优化的,cross-attention 层期望输入 1024 维的 T5 风格向量。Qwen3 输出的维度刚好也是 1024,维数对得上,但语义分布和 T5 不一样,直接塞进去效果差。于是中间插了一个可训练的 6 层 Transformer「桥」,叫 LLM Adapter。它的做法是:拿 T5 分词器生成的 token 序列(512 个 token id)当「骨架」,拿 Qwen3 的输出当「语义来源」,用交叉注意力把 Qwen3 的语义逐 token 写进 T5 骨架,最后输出 DiT 要的 512×1024 条件向量。打个比方,Qwen3 是会外语的翻译官,Adapter 是口译员,把外语翻成 DiT 听得懂的本地话。
10.4 双分词管线的运作方式
Anima 的文本编码管线同时用两个分词器:Qwen3 分词器把提示词切成 Qwen3 能懂的 token,送进 Qwen3 拿语义嵌入;T5 分词器把同一段提示词切成 T5 格式的 token,作为 Adapter 的骨架输入。要两个分词器的原因是,Adapter 需要 T5 骨架当「槽位」,语义内容从 Qwen3 填进来,这是工程上的桥接做法,不是设计冗余。训练时两个分词器都不更新,只有 Adapter 学怎么把 Qwen3 的语义映射到 T5 骨架里。
第 11 章 DiT 主干 —— Transformer 如何生成图像
章节说明:本章深入 Anima 最核心的生成网络,解释「Transformer 怎么用来画画」。
11.1 从像素到 Patch 再到 Token(PatchEmbed)
直接处理像素很难。一张 1024×1024 的图有 300 多万个值,Transformer 自注意力的复杂度是 O(n²),啃不动这么大的序列。解决办法(和 VAE 压缩还不一样)是 PatchEmbed:把潜空间特征(16×128×128)按 2×2 的空间块切,每块 16×2×2=64 个值,展平后过一层线性投影到 2048 维(实现里还会拼上少量填充通道,投影输入实际是 68 维)。结果 128×128 的潜空间被切成 (128/2)×(128/2)=4096 个 patch,每个 patch 变成一个 2048 维的 token,DiT 处理的就是这 4096 个 token 的序列。可以把这想象成把一幅画切成 4096 块拼图,每块装进一个信息包,Transformer 负责处理这些信息包之间的关系。
11.2 28 层 Block 的内部结构
每个 Transformer Block 有三个按顺序执行的子层。自注意力让 4096 个 token 互相「看」,捕捉画面里不同位置的空间关系,比如头发和肩膀的位置关系;交叉注意力让这 4096 个 token 去「看」来自 Adapter 的 512 个文本 token,把提示词的语义灌进生成过程;前馈网络(MLP)对每个 token 独立做非线性变换,增强表示能力,类似 Transformer 的 FFN,GPT-2 风格、GELU 激活。三个子层都带残差连接和 AdaLN 条件调制(见 11.4)。base 版有 28 层 Block,每层结构一样、参数独立。
11.3 位置编码:3D RoPE 与 NTK 外推
Transformer 本身是顺序无关的,它不知道 token 在画面哪个位置,得额外塞位置信息。Anima 用 3D RoPE(旋转位置编码),沿高、宽、时间三个维度分别编码位置。时间维在 Anima 里主要用于图像(T=1),但架构保留了视频扩展能力;高和宽两个维度各配独立旋转频率。另外 Anima 给 h/w 轴设了 4.0 倍的 NTK 外推倍率:训练时见到的最大分辨率是 1024²(对应 128×128 潜空间),推理时靠 RoPE 的 NTK 缩放,能外推到 1536² 甚至更高而不严重失真。位置编码好比给每块拼图贴上「第几行第几列」的标签,NTK 外推让这些标签在画面放大后依然定位得准。
11.4 条件调制:AdaLN-LoRA
扩散模型得知道「现在是去噪第几步」(时间步 t),才能决定去噪的强度和策略。Anima 的做法是,每个 Block 的三个子层前都放一个 AdaLN(自适应层归一化)调制模块,时间步 t 被编码成向量,过一个小网络生成 shift(偏移)、scale(缩放)、gate(门控)三个参数,作用在层归一化后的特征上。AdaLN-LoRA 特别在用了低秩设计,把调制参数压到 256 维低秩空间再投回来,既省参数又不失灵活。效果就是,时间步 t 靠这套机制告诉模型「现在还早,先画轮廓」或「到后期了,该补细节」。
11.5 稳定训练技巧:QK-Norm
Transformer 训练常有个毛病:注意力分数(Q 和 K 的点积)可能过大,导致梯度不稳。Anima 的解法是,算点积前分别对 Q、K 做 RMSNorm(均方根归一化),把模长控制在稳定范围。这是近几年 LLM 和 DiT 里验证有效的稳定化手段,让 Anima 大规模训练时更稳。
11.6 参数量估算
把官方权重文件(safetensors)直接拆开数了一遍:DiT 主干共 2,091,068,928 个参数,约 2.09B,和官方「2B」的口径一致。其中 28 个 Transformer Block 每层约 6,920 万参数,合计约 1.94B;剩下的约 1.5 亿参数是 PatchEmbed、时间步嵌入、Final Layer、T5 词表嵌入和 LLM Adapter 这些外围模块。把 Qwen3(5.96 亿)和 VAE(1.27 亿)也加进来,三个文件合计约 2.8B。作为参照,SDXL 的 U-Net 约 2.6B,两者量级相近,但架构完全不同。
第 12 章 VAE —— 16 通道潜在空间
章节说明:解释 VAE 的压缩/解压作用,以及 16 通道设计的技术含义。
12.1 VAE 的压缩与重建作用
VAE(变分自编码器)分编码器和解码器两块:编码器把输入图(3 通道 RGB,1024×1024)压成更小的潜在表示(16 通道,128×128),解码器再把潜在表示还原回像素空间。压缩倍率上,空间 8× 下采样(1024→128)、通道从 3 增到 16,总信息量大减,扩散模型才能在潜空间高效操作。有一点别误会,VAE 自己不「生成」新内容,它只是个还原度很高的编解码工具,压缩本身有损,只是肉眼基本看不出来。
12.2 技术规格
Qwen-Image VAE 的具体规格:
| 项 | 值 |
|---|---|
| 基础通道数 | 96 |
| 通道倍增配置 | [1, 2, 4, 4],即各层输出通道为 96、192、384、384 |
| 残差块数 | 每层 2 个 |
| 注意力模块 | 无(attn_scales=[]),是纯卷积 VAE |
| 潜在空间通道数 | 16(z_dim=16) |
| 时间维下采样 | 支持视频但图像场景 T=1 不受影响 |
潜在空间的每个通道都有独立的均值(mean)和标准差(std),用于归一化和反归一化。
12.3 与 SDXL(4 通道 VAE)的差异
SDXL 的 VAE 是 4 通道,Anima 是 16 通道。16 通道意味着每个空间位置装的信息更丰富,DiT 首层投影的输入维度是 16×2×2=64(patch 2×2),末层反投影是 64→16。设计取向也不同:Anima 的 VAE 不含注意力层(attn_scales=[]),长程依赖全交给 DiT;SDXL 的 VAE 带注意力层,自身就有一点全局建模能力。这是两种架构的取舍,没有谁更好。Anima 的 DiT 已经扛了全局注意力,VAE 专心做压缩,分工更清楚。
第 13 章 Rectified Flow 流匹配与生成机制
章节说明:解释 Anima 的预测目标和生成框架跟传统 DDPM 有何不同,以及这种不同对 CFG、步数这些使用体验的实际影响。
13.1 预测目标:噪声 ε vs 速度场 v
扩散模型里有两个经常被当成一回事、其实是独立选择的维度:预测目标和生成框架。这一节先讲预测目标,生成框架放到 13.3。
预测目标,说的是模型训练时到底回归什么。主流两种。ε-prediction 预测加进去的噪声,给一张加了噪的图让模型猜里面混了多少噪声,采样时再减掉;v-prediction 预测速度场 v(v = α·ε − σ·x₀),给当前状态直接预测「往干净图方向该走多快、朝哪走」。
一个容易被搞反的先后关系:v-prediction 不是 Rectified Flow 带来的。它最早是 Salimans & Ho 在 2022 年 2 月的《Progressive Distillation》里、在 DDPM 离散框架内部提出的,本意是让蒸馏和 zero-SNR 训练时数值更稳;Rectified Flow 是同年 9 月才出现的另一个框架,只是它天然用速度场当训练目标。准确说是「Rectified Flow 沿用了更早的 v-prediction」,反过来讲就错了。
因为两个维度正交,DDPM 框架里既能预测 ε 也能预测 v。NoobAI-XL V-Pred 就是留在 DDPM 框架、只把目标从 ε 换成 v 的例子,还配了 zero-SNR 调度。ε-prediction 像在雾里找回家的路,每一步都在猜雾有多浓;v-prediction 像手里攥着一张直达地图,往哪走、走多远,抬手就能看到。总体上 v-prediction 数值更稳、采样路径更直接。
13.2 为什么 Anima 的 CFG 推荐 4–5(而 SDXL 要 7–9)
CFG(分类器自由引导)是在条件生成和无条件生成之间放大差值,来增强提示词的影响。ε-prediction 下,无条件和有条件预测的差异不大,得用高 CFG(7–9)才够引导强度,但太高容易过饱和、对比失真;v-prediction 下,速度场方向更明确,两种预测的差异天然更大,CFG 只要 4–5 就够,还不容易过饱和。这是预测目标带来的特性,不是 Anima 的「调校偏好」。
13.3 生成框架:离散 DDPM vs 连续流匹配
接着 13.1 说第二个维度,生成框架,也就是时间轴怎么走。传统 DDPM 把去噪离散成 1000 个整数步(t=0, 1, 2, …, 999),模型只在这 1000 个点上学习。Rectified Flow 用连续时间域 t ∈ [0, 1],时间步可以取任意实数,模型靠学连续时间上的速度场来泛化到任意步长。好处是推理时想用几步就几步(10、20、30、50 都行),不用被训练时的离散步数绑住,步数越少越快,质量下降也平缓。
13.4 timestep 采样策略:anima_shift 分辨率自适应
训练时,时间步 t 的采样分布会影响模型在不同噪声强度下的表现。Anima 支持多种采样策略(uniform、sigmoid、shift、flux_shift),其中 anima_shift 是专门为分辨率自适应设计的。原理是,高分辨率图细节多,需要把更多「去噪预算」压在高噪声段,所以 anima_shift 会按当前训练图的分辨率动态调时间步采样分布:1024²(基准)时 α=1.0、偏移 0、分布不变;分辨率更高(如 1536²)时 α>1.0,采样分布往高时间步偏,模型在高噪声段练得更多。这样一来,Anima 能同时在多种分辨率上训练和推理,跨分辨率迁移也更好。
第 14 章 Anima vs SDXL —— 全面客观对比
章节说明:用一张大表和逐项讨论,客观呈现 Anima 与 SDXL 的异同。
14.1 架构对比一览表
| 维度 | Anima(Anima-base) | SDXL |
|---|---|---|
| 主干类型 | DiT(纯 Transformer) | U-Net(CNN + 注意力) |
| 主干参数量 | ≈ 2.09B(28 层 × 2048 维) | ≈ 2.6B(U-Net) |
| 主干处理方式 | 4096 tokens @ 1024²(patch 2×2) | 64×64×4 = 16384 潜空间特征 @ 1024² |
| 生成框架 | Rectified Flow(v-prediction) | DDPM(ε-prediction) |
| 时间域 | 连续 [0, 1] | 离散 1000 步 |
| 噪声调度 | 线性插值(流匹配) | 固定 β 调度 |
| 文本编码器 | Qwen3-0.6B(单编码器) | OpenCLIP ViT-bigG + ViT-L(双编码器) |
| 文本 token 数 | 512(Qwen3)+ 512(T5 骨架) | 77 + 77 = 154 |
| 文本注入方式 | Adapter 桥 → cross-attn(每 block) | 双编码器输出 concat → cross-attn + pooled → adaGN |
| 文本桥模块 | 6 层 Transformer(≈134M) | 无 |
| 潜在通道 | 16 通道,8× 压缩 | 4 通道,8× 压缩 |
| VAE 类型 | Qwen-Image VAE(纯卷积,无注意力) | SDXL KL-VAE(含注意力) |
| 位置编码 | 3D RoPE + NTK 外推(h/w 4.0×) | 无(卷积平移不变) |
| 注意力归一化 | QK-Norm(RMSNorm)+ RoPE(仅 self) | 标准 MHA,无 QK-norm |
| 条件调制 | AdaLN-LoRA(shift/scale/gate,256维低秩) | adaGN(时间嵌入 shift/scale) |
| 归一化方式 | LayerNorm(无 affine)+ RMSNorm | GroupNorm |
| 推荐采样器 | Euler / dpmpp_2m_sde_gpu | DDIM / DPM++ |
| 推荐步数 | 30–50 | 30–50 |
| 推荐 CFG | 4–5 | 7–9 |
| 原生分辨率 | 512²–1536²(H/W 需被 16 整除) | 1024²(H/W 需被 64 整除) |
| 分辨率外推 | RoPE NTK 外推(显式机制) | U-Net 天然任意分辨率但质量随尺寸下降 |
| 生态成熟度 | 较新,生态成长中 | 成熟,全网最完整生态 |
14.2 各自的机制性优势
Anima 这边:文本理解上限高,Qwen3 的 512 token 能精确读复杂指令和长句,比 SDXL 双 CLIP 的 77×2 强太多;低 CFG 稳定,4–5 就有好引导,色彩对比更自然;步数弹性好,连续时间训练支持任意步数,Euler 30 步就有高质量;显式分辨率外推,RoPE + NTK + anima_shift 是一套可解释、可调的分辨率自适应机制;架构现代,纯 Transformer 方便复用 LLM 社区的优化工具。
SDXL 那边:生态成熟度碾压,ControlNet 全家桶、IP-Adapter、AnimateDiff、海量插件和工作流,社区资源最全;可控生成工具链完整,姿态、深度、线稿各类控制条件都有成熟实现;U-Net 卷积先验在多尺度特征上有天然的多分辨率感受野,极高分辨率(如 2048²)的扩展推理成本比 DiT 全局自注意力低;长期验证稳定,2023 年发布至今被海量用户踩过坑,训练推理的坑基本都填平了。
14.3 各自的机制性局限
Anima 这边:自注意力是二次方成本,4096 token 的全局注意力在高分辨率下 token 数暴涨(2048² 就是 16384 tokens),显存和算力开销大,靠 RoPE 外推而不是直接高分辨率训练;生态年轻,可控生成目前主要是 ControlNet-LLLite,覆盖远不如 SDXL;双分词器加 Adapter 多了层复杂度,LLM Adapter 依赖 T5 骨架,如果 T5 分词和目标提示词语义有偏差会引入损耗;信息瓶颈上,16 通道 VAE 加纯卷积设计,VAE 自己不建模长程依赖,全局关系全压给 DiT。
SDXL 那边:文本理解受限,CLIP 77 token 处理长提示词会截断、丢细节;高 CFG 副作用,7–9 容易过饱和、色彩溢出,得靠负向提示词和采样器技巧去调;分辨率外推没保障,U-Net 虽能跑任意分辨率,但高分辨率下易出重复纹理、结构崩塌,得靠外部高清修复流程兜底;架构接近寿命末端,U-Net + DDPM 已非当前 SOTA 方向,社区和厂商的关注在往 DiT、流匹配迁移。
附录(供读者随时查阅)
附录 A:术语表
| 术语 | 人话解释 |
|---|---|
| DiT | Diffusion Transformer,用 Transformer 做扩散生成的主干网络 |
| VAE | 变分自编码器,负责图像的压缩和解压 |
| RoPE | 旋转位置编码,给 Transformer 的 token 注入位置信息的一种方式 |
| NTK 外推 | 一种缩放旋转频率、让模型支持更高分辨率的技术 |
| CFG | 分类器自由引导,控制提示词影响力的参数 |
| Rectified Flow | 一种生成框架,训练目标为预测速度场(v-prediction) |
| v-prediction | 速度场预测,直接预测「噪声→干净图」的移动方向 |
| ε-prediction | 噪声预测,传统扩散模型预测「混入了多少噪声」 |
| DDPM | 去噪扩散概率模型,传统扩散模型的数学框架 |
| U-Net | 一种带跳跃连接的卷积网络,SDXL 的主干架构 |
| Transformer | 基于自注意力的神经网络架构,LLM 的核心组件 |
| Attention / 自注意力 | 让 token 之间互相「看」、捕捉相互关系的机制 |
| Cross-Attention / 交叉注意力 | 让图像 token「看」文本向量、注入语义的机制 |
| AdaLN | 自适应层归一化,用时间步调制每一层特征 |
| AdaLN-LoRA | 低秩版 AdaLN,把调制参数压缩到低秩空间 |
| QK-Norm | 对注意力里的 Q 和 K 做归一化,稳定训练 |
| RMSNorm | 均方根归一化,一种轻量的归一化方法 |
| LayerNorm | 层归一化,另一种常见的归一化方法 |
| PatchEmbed | 把潜空间切成小块并投影成 token 的模块 |
| Tokenizer / 分词器 | 把文字切成 token 序列的工具 |
| Token | 文本或图像被切分后的最小处理单元 |
| Text Encoder / 文本编码器 | 把提示词翻译成向量的模型(Anima 用 Qwen3) |
| LLM Adapter | 把 Qwen3 语义桥接到 T5 兼容空间的 6 层桥 |
| Latent / 潜空间 | VAE 压缩后的低维特征空间 |
| Sampler / 采样器 | 控制去噪「行走路径」的算法 |
| Scheduler / 调度器 | 控制噪声随时间衰减方式的模块 |
| Steps / 步数 | 去噪过程的迭代次数 |
| Seed / 种子 | 决定初始噪声的随机序列号,用于复现 |
| LoRA | 轻量附加模块,给底模增加画风/角色/概念 |
| Hugging Face | 模型权重托管平台 |
| ComfyUI | 节点式 AI 绘画图形界面 |
| safetensors | 一种安全的模型权重文件格式 |
| Rectified Flow 采样器 | Anima 的采样调度器,连续时间 [0,1] |
附录 B:常见问题 FAQ
Q1:为什么生成结果和别人不一样?
A:生成结果由「提示词 + 参数 + 随机种子」共同决定。只要种子不同(默认 -1 随机),或任何参数、提示词有细微差异,结果就会不同。想复现某张图,需要完全相同的提示词、参数和种子。
Q2:Anima 能不能生成写实风格?
A:Anima 的训练数据以动漫/二次元风格为主,强项在动漫风格。靠提示词硬调也能出几张,但一般不如专门的写实模型,想写实建议直接换模型。
Q3:显存不足怎么办?
A:按优先级尝试:① 降低分辨率(1024→768→512);② 降低批大小;③ 启动 ComfyUI 时加 --lowvram 或 --novram;④ 关闭其他占用显存的程序。
Q4:生成速度太慢怎么办?
A:① 减少采样步数(50→30);② 换用 dpmpp_2m_sde_gpu 或 euler;③ 降低分辨率;④ 确认显卡驱动为最新版。
Q5:提示词写中文可以吗?
A:Anima 主要针对英文提示词训练,建议写英文。中文可以写,但理解和生成质量通常不如英文。可以用翻译工具先把中文需求译成英文。
Q6:报错「CUDA is not available」怎么办?
A:显卡驱动未安装或版本过低,去 NVIDIA 官网更新驱动后重试。
Q7:报错「CUDA out of memory」怎么办?
A:见 Q3,本质是显存不够。
Q8:报错「Checkpoint file not found」怎么办?
A:模型文件路径不正确,回看第四章,确认 DiT 放在 models/diffusion_models/ 下且文件名一致。
Q9:报错「Node type not found」怎么办?
A:工作流使用了未安装的自定义节点,去 ComfyUI Manager 安装对应缺失节点。
Q10:生成结果全黑或全灰怎么办?
A:大概率是 VAE 加载失败或连接错误,检查 VAE 节点是否连接正确、VAE 文件是否完整。
Q11:CFG 应该设多少?
A:Anima 推荐 4–5,远低于 SDXL 的 7–9。不要按 SDXL 的习惯去设。
Q12:采样步数设多少合适?
A:30–50 步性价比最高,超过 80 步基本无肉眼可见提升。
Q13:分辨率必须 1024×1024 吗?
A:不必。1024² 是原生训练分辨率、效果最稳。可以用其他尺寸,但 H 和 W 都必须能被 16 整除(VAE 8× 下采样 × DiT 2×2 patch = 16)。
Q14:可以用非正方形分辨率吗?
A:可以,如 1024×1536,只要两边都能被 16 整除即可。
Q15:正向和负向提示词都要写质量标签吗?
A:推荐都写。正向写 masterpiece, best quality,负向写 worst quality, low quality,双管齐下更稳定。
Q16:标签式提示词和句子式提示词哪个好?
A:Anima 两种都理解,且可混用。推荐「质量标签 + 主体标签 + 2–3 句自然语言描述」的混合写法。
Q17:权重语法 (word:1.3) 里的数字范围多少合适?
A:有效范围通常 0.5–1.5。Anima 对权重敏感度略低于 SDXL,从 1.2 开始试,必要时到 1.5。
Q18:LoRA 权重设多少?
A:通常 0.6–1.2 之间,太大会导致画面崩坏。
Q19:模型文件要下载几个?
A:三个:DiT 主干(~4.2GB)、文本编码器(~1.2GB)、VAE(~0.25GB)。
Q20:可以只下载一个文件就跑吗?
A:不能。Anima 需要三个组件协同工作,缺一不可。
Q21:AMD 显卡能用吗?
A:Anima 主要针对 NVIDIA(CUDA)优化,AMD 显卡需要额外配置,体验可能不如 NVIDIA。
Q22:生成的时候命令行窗口能关吗?
A:不能。那个窗口是 ComfyUI 的服务进程,关掉就等于停止服务。生成完、不再用的时候再关。
附录 C:官方资源汇总
- Hugging Face 模型仓库:
https://huggingface.co/circlestone-labs/Anima - ComfyUI 官方仓库:
https://github.com/comfyanonymous/ComfyUI - 官方 ComfyUI 工作流模板:Hugging Face 仓库
README.md内的示例图片(拖拽导入) - 官方推荐的在线体验与社区平台(摘自官方模型卡):
- CivitAI 模型页:
https://civitai.com/models/2458426/anima - TensorArt:
https://tensor.art/models/998619401697644790/Anima-Official-circlestone_labs-base-v1.0 - KusArt:
https://kusart.com - IMGNAI:
https://imgnai.com/ - mage:
https://www.mage.space/ - AliveAI:
https://aliveai.app/ - DreamerLand:
https://www.dreamerland.ai/ - 推荐社区工具:ComfyUI Manager(插件/工作流管理)、自制工作流分享站等
全文完
home.comments.title
home.comments.unavailable