
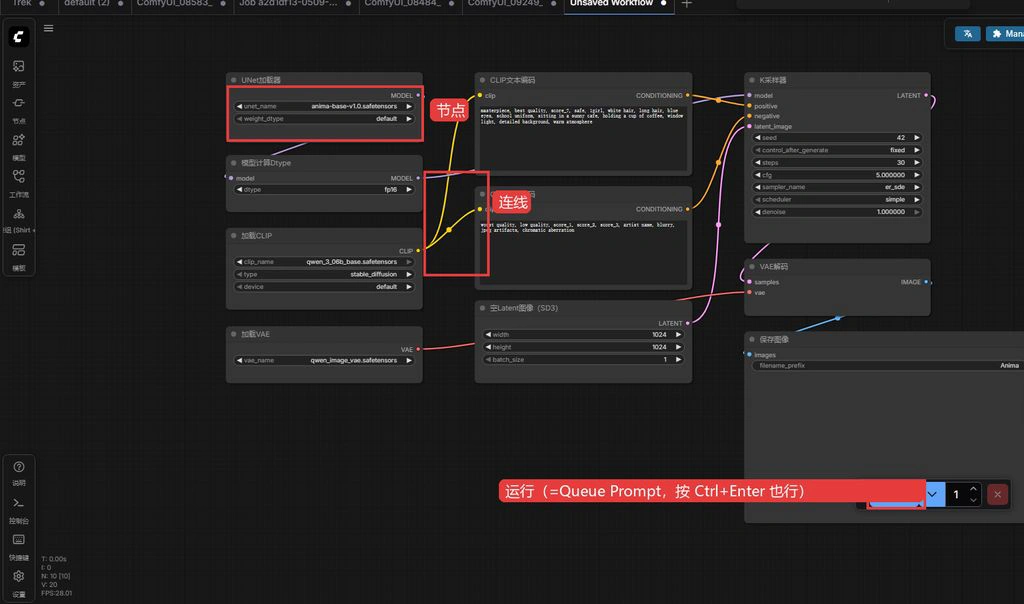
本教學共 14 章,外加三個附錄,分四步走。前兩章講原理和定位,先畫一張地圖,用大白話講清楚 AI 畫圖到底是怎麼回事,再引出 Anima 是什麼。第三到第六章是純實操,裝 ComfyUI、下模型、配工作流、出第一張圖,全程手把手。第七、八章練生成技巧,講參數怎麼調、提示詞怎麼寫,完成從「能出圖」到「能出好圖」的進階。最後六章拆模型架構,逐層講 Anima 是怎麼實現的,再用一張大表和 SDXL 做個對照。附錄放術語表、常見問題和資源連結,隨手查。
本章目標:用不超過 2500 字、零數學公式、全類比的方式,讓完全沒接觸過 AI 繪圖的新手理解「擴散模型是怎麼工作的」。不涉及任何具體模型,只講通用框架。
一個美術生是怎麼學會畫畫的?從小到大看成千上萬幅作品,一遍遍臨摹,畫得不像就重來。臨多了,慢慢摸出規律:眼睛該在臉的什麼位置,光從左邊打來陰影落在哪,什麼筆觸能畫出毛髮的質感。到最後不用參考圖,也能憑經驗畫出全新的東西。AI 畫圖模型走的是同一條路。它「看」了幾億張圖,記住的不是哪一張具體圖片,而是畫素排列的統計規律:什麼樣的畫素組合像頭髮、像天空、像人的眼睛。給它一段文字,它就能按這些規律重新組合出一張新圖。這裡有個誤解得先講清楚:AI 不是從相簿裡剪一塊拼上去,也不是在「抄襲」哪張已有的圖,它輸出的每一個畫素都是現場算出來的。
Anima 這類擴散模型的工作方式,可以拆成兩個完全相反的過程。訓練階段是一場「破壞與復原」的遊戲:取一張清晰圖,逐步往上加隨機噪聲,越加越多,直到整張圖變成一片雪花點,完全看不出原來是什麼;讓 AI 反覆看「從清晰到模糊」的每一步,它學到的就是逆向的規律,怎麼把模糊重新變清晰。生成階段反著來,從一張純噪聲圖起步,此時它腦子裡什麼都沒有,只靠輸入的文字提示,一步步去掉噪聲、還原出清晰畫面。每步只去掉一小點噪聲,就像從極度模糊慢慢對焦。整個過程可以想像成一段倒放影片:一張清晰照片先被打滿馬賽克,AI 再學著把馬賽克一層層揭掉。
這裡有個現實問題。如果直接在畫素層面動手,一張 1024×1024 的圖有 100 多萬個畫素點,按 RGB 三通道展開是 300 多萬個數值,每一步加噪去噪都要在這 300 萬個值上算,普通電腦扛不住。所以得「先壓縮、再創作、最後解壓」:先用一個壓縮器(VAE 編碼器)把圖片壓成小得多的特徵圖,加噪去噪都在這個壓縮後的潛空間裡完成,最後再用解壓器(VAE 解碼器)還原成高畫質圖。拿 Anima 說,它的 VAE 在空間上把 1024×1024 壓到 128×128,每邊縮小 8 倍、面積縮小 64 倍,同時用 16 個通道裝資訊。這麼一來,擴散模型真正要處理的潛空間表示只有 128×128×16,約 26 萬個數值,比原來的 314 萬畫素少了大約 12 倍。就像剪一個特別大的影片,先壓成小體積的代理檔案,剪完再渲染回高畫質,VAE 乾的就是壓縮和解壓這兩件事。
提示詞是文字,AI 處理的是數字,所以文字得先翻譯。文字編碼器(Text Encoder)把提示詞變成一串數字向量,叫語義嵌入,也叫條件向量。去噪的每一步,這些向量會通過一種叫交叉注意力(Cross-Attention)的機制,告訴擴散模型下一步該往哪個方向去噪、畫面裡該出現什麼。說白了,提示詞就是遞給 AI 的一張文字地圖,它每走一步都掏出地圖確認方向,免得跑偏,最後走到描述的目的地。
把上面四個環節串成一條流水線:
文字提示詞 → 文字編碼器 → 語義向量
隨機噪聲(潛空間) + 語義向量 → 擴散模型逐步去噪 → 去噪完成後的潛空間特徵
潛空間特徵 → VAE 解碼器 → 最終高畫質圖片
所有主流 AI 繪圖模型都遵循這個框架,區別只在於每個環節用了什麼具體技術。Anima 也不例外,下一章就把它對號入座。
說實話,這一章是對真實過程的極度簡化,數學公式、具體的網路結構、取樣排程的細節、CFG 的計算方式,全都沒講。只想會上手,讀到這裡已經足夠;想弄懂具體實現的,第四部分會用同樣的大白話逐塊拆開講。
本章目標:承接第 1 章,把通用框架映射到 Anima 的具體元件上,讓讀者知道「Anima 就是按照這個框架做出來的模型」,形成整體認知。
Anima 是個文生圖模型,輸入文字,輸出動漫、二次元風格的圖片,由 circlestone-labs 和 Comfy Org 合作發布,權重放在 Hugging Face(circlestone-labs/Anima)。DiT 主幹有 20 層、28 層、36 層三種規格,官方主推的 2B 版是 28 層、約 2.1B 參數,技術基座是 NVIDIA Cosmos-Predict2 的 Text2Image 架構加 Rectified Flow 生成框架。官方按用途還發了三個版本:Base 是預訓練底模,Aesthetic 是品質微調版,Turbo 是蒸餾加速版、CFG 1 加 8–12 步就能出圖,新手建議從 Turbo 上手。
把第 1 章的通用概念和 Anima 的具體實現一一對上:
| 通用概念 | Anima 的具體元件 |
|---|---|
| 文字編碼器(把文字翻譯成向量) | Qwen3-0.6B(基於現代大語言模型的編碼器,支援 512 token 長上下文) |
| 文字適配橋接(可選) | LLM Adapter(6 層 Transformer,把 Qwen3 的語義空間映射到擴散模型能理解的空間) |
| 潛空間壓縮器(VAE 編碼器) | Qwen-Image VAE(16 通道輸出,空間 8× 壓縮) |
| 潛空間解壓器(VAE 解碼器) | Qwen-Image VAE(與編碼器對稱) |
| 擴散去噪主幹(在潛空間操作的核心網路) | DiT(Diffusion Transformer),28 層 Transformer,2048 維隱藏狀態,16 個注意力頭 |
| 去噪方式 / 訓練目標 | Rectified Flow(流匹配),採用速度場預測(v-prediction),而非傳統 DDPM 的噪聲預測(ε-prediction) |
| 取樣排程器 | FlowMatchEulerDiscreteScheduler,連續時間 [0, 1] 區間,推薦步數 30–50 |
Anima 的自然語言理解能力明顯更強。Qwen3 是正經的大語言模型,512 token 上下文能準確讀懂複雜長提示詞,把 SDXL 的 CLIP(77 token×2)甩開一大截。它在低 CFG 下也很穩,Rectified Flow 框架下 CFG 只要 4–5,遠低於 SDXL 的 7–9,出圖不容易過飽和。少步數也能用,Euler 取樣器跑 30 步就有高品質輸出,不用依賴高階取樣器。它還能把解析度往外推,1536² 直接就能跑。
本部分目標:讓完全沒接觸過 ComfyUI 的讀者,在 30–40 分鐘內完成安裝、下載、配置並生成第一張 Anima 圖。不講原理,只教操作。
章節說明:ComfyUI 是執行 Anima 最可靠、官方最推薦的圖形介面。本章教讀者從零安裝。
ComfyUI 是一個節點式的 AI 繪畫軟體,通過連線一個個功能模組(節點)來搭建生成工作流。選它是因為 Anima 官方原生支援,社群工作流最豐富,視訊記憶體最佳化也最好。
官方 GitHub 倉庫地址是 https://github.com/comfyanonymous/ComfyUI。Windows 使用者推薦下載 ComfyUI_windows_portable_nvidia.7z(NVIDIA 顯示卡首選,自帶 Python 環境和依賴,解壓即用;AMD / Intel 顯示卡選對應的 amd / intel 版本)。Mac、Linux 使用者在倉庫頁面找對應的安裝說明。不建議從非官方來源下載,安全第一。
下載後解壓到任意位置,路徑最好別帶中文和空格,比如 D:\ComfyUI。解壓完,目錄裡幾個資料夾的用途如下:
| 資料夾 | 用途 |
|---|---|
| models/ | 存放所有模型檔案(DiT、VAE、文字編碼器、LoRA 等) |
| custom_nodes/ | 存放第三方擴充套件外掛 |
| output/ | 生成的圖片預設儲存位置 |
| input/ | 輸入圖片(如用於圖生圖)存放位置 |
Windows 下雙擊 run_nvidia_gpu.bat 啟動(NVIDIA 顯示卡),沒獨顯就用 run_cpu.bat。啟動時命令列視窗會彈出、滾動刷日誌,這很正常,先不要關。當末尾出現 http://127.0.0.1:8188 就說明啟動成功了。開啟瀏覽器,位址列輸入這個地址回車,看到介面就算成。
CUDA is not available:顯示卡驅動沒裝或版本太低,去 NVIDIA 官網更新驅動。Out of memory:視訊記憶體不夠,啟動參數加 --lowvram 或 --novram 試試。No module named 'torch':Python 環境依賴缺失,重新解壓便攜版或執行 install.py。章節說明:Anima 不是單個檔案就能跑,它需要三個獨立元件協同工作。本章讓讀者清楚知道「需要下載什麼」「放在哪裡」。
| # | 檔案 | 作用 | 大小預估 |
|---|---|---|---|
| 1 | DiT 主幹(anima-base-v1.0.safetensors) | 負責核心的去噪生成過程,是最大的檔案 | 約 4.2 GB |
| 2 | 文字編碼器(qwen_3_06b_base.safetensors) | 把提示詞翻譯成 AI 能理解的語義向量 | 約 1.2 GB |
| 3 | VAE(qwen_image_vae.safetensors) | 潛空間與畫素空間之間的壓縮與解壓 | 約 0.25 GB |
官方倉庫地址是 https://huggingface.co/circlestone-labs/Anima。開啟頁面點 Files 標籤,在檔案列表裡找到上面三個 .safetensors,逐個點右邊的下載按鈕(↓)。網慢的話可以用 Hugging Face 映象站,或者 huggingface_hub 命令列。注意別下無關檔案(.gitattributes、README.md 這些),只下三個 .safetensors。
以解壓後的 ComfyUI 根目錄為 ComfyUI/,三個檔案分別放到:
ComfyUI/models/diffusion_models/anima-base-v1.0.safetensors
ComfyUI/models/text_encoders/qwen_3_06b_base.safetensors
ComfyUI/models/vae/qwen_image_vae.safetensors
models/ 下如果沒有 diffusion_models/ 或 text_encoders/ 資料夾,手動建一個就行。
重啟 ComfyUI(關掉命令列視窗再雙擊 .bat),在啟動日誌裡搜檔名。看到 Loading diffusion model: anima-base-v1.0.safetensors 且沒報錯,就對了。要是出現 File not found 或 No such file,查一下路徑是不是寫錯、檔名有沒有多餘字尾。
章節說明:有了模型檔案,還得有個「工作流」告訴 ComfyUI 怎麼把這些檔案連起來。本章教讀者獲取官方工作流並載入。
工作流是個 .json 檔案,記錄了所有節點的位置、連線和參數。模型檔案是食材,工作流是菜譜,沒有菜譜,食材堆那兒也不知道怎麼做。ComfyUI 有個貼心功能:能把工作流直接嵌進生成的圖片裡,所以把別人生成的圖拖進來,對應的完整工作流就會自動載入。
README.md 頁面裡找到官方示例圖,直接拖進 ComfyUI 介面即可匯入工作流。以「拖圖片匯入」為例:開啟 ComfyUI,把官方示例圖拖到工作區鬆手,工作流自動彈出。然後檢查三個模型節點指向的檔案對不對:「Load Diffusion Model」應顯示 anima-base-v1.0.safetensors,「Load Text Encoder」應顯示 qwen_3_06b_base.safetensors,「Load VAE」應顯示 qwen_image_vae.safetensors。不對的話,點節點上的檔案選擇框重選。
章節說明:萬事俱備,本章讓讀者真正按下生成按鈕,看到自己的第一張 Anima 作品,這是整個教學裡最有成就感的一步。
在工作流裡找到「CLIP Text Encode (Prompt)」節點(正向提示詞節點),文字框裡輸入下面這段,直接複製即可:
masterpiece, best quality, score_7, safe, 1girl, white hair, long hair, blue eyes, school uniform, sitting in a sunny cafe, holding a cup of coffee, window light, detailed background, warm atmosphere
這段的大意是:一個白頭髮、藍眼睛的女學生坐在咖啡廳裡。不用逐詞翻譯,知道這是「一個人物加場景的描述」就行。
找到「CLIP Text Encode (Prompt)」節點裡帶 negative 標識的那個(負向提示詞節點),輸入:
worst quality, low quality, score_1, score_2, score_3, artist name, blurry, jpeg artifacts, chromatic aberration
負向提示詞的作用是告訴 AI 要排除什麼,比如低畫質、低分、模糊、JPEG 偽影、色差這些。
1024 x 1024,批大小(Batch Size)設 1(一次只出一張)。30、CFG(CFG Scale)5.0、取樣器(Sampler)euler、排程器(Scheduler)normal 或 simple。點介面右側的「Queue Prompt」(或按 Ctrl+Enter),盯著命令列視窗的進度條,等 10–30 秒(看顯示卡效能)。出圖後,圖片會出現在工作區的輸出節點裡,右鍵能存到本地,ComfyUI/output/ 資料夾裡也能找到。到這一步,第一張 Anima 圖就完成了。
models/diffusion_models/ 下。--lowvram。qwen_image_vae.safetensors 覆蓋。本部分目標:讀者已經能出圖,但可能「隨機性很強,不知道怎麼控制」。本部分通過對比圖講清每個參數的作用,並教會讀者用提示詞精準控制畫面。
章節說明:本章每一節都配並排對比圖(同一種子、只變一個量),讓讀者直觀看到參數對畫面的影響。
解析度就是輸出圖片的長寬畫素數。Anima 官方支援 512² 到 1536²,原生訓練解析度是 1024×1024,建議以它為基準:512×512 會糊、丟細節,768×768 能用但偏軟,1024×1024 是甜點位,1536×1536 細節最足但吃視訊記憶體。視訊記憶體和解析度是平方關係,解析度翻一倍,畫素數翻四倍。長寬比可以改,比如 1024×1536 這種豎圖,但 H 和 W 都得能被 16 整除,這是 Anima 的結構約束(VAE 空間 8× 下采樣,DiT 再按 2×2 切 patch,合起來 8×2=16)。
取樣步數就是去噪迭代的次數,每步去掉一點噪聲。同一提示詞在不同步數下差別挺明顯:10 步畫面糊、結構不全;20 步基本成形但細節糙;30 步清晰銳利、細節足,是推薦起步值;50 步提升有限,邊際收益遞減。所以 30–50 步最划算,超過 80 步肉眼基本看不出差別,純屬多等。
CFG 控制模型「聽提示詞的程度」。數值越高,畫面越貼提示詞,但容易過飽和、顏色失真;越低,模型越自由,可能跑偏。同一提示詞在不同 CFG 下:1.0 基本不理提示詞,畫面隨機;3.0 大致照著來但偏平淡;5.0 是平衡點,畫質和相關性都好(Anima 推薦值);7.0 顏色加深、對比增強,可能輕微過飽和;10.0 顏色過猛,可能出偽影或畫風突變。這裡要特別提醒一句:Anima 推薦 CFG 是 4–5,比 SDXL 的 7–9 低不少,這是 Rectified Flow 框架的特性,照搬 SDXL 的調參習慣會把顏色推過頭。
取樣器決定去噪的「行走路徑」,不同取樣器在步數和品質之間做不同取捨。不用全列,Anima 上幾個常用的:er_sde 是作者自己推薦的預設,風格中性、色塊平、線條利落;euler 稍多點創意,配 Turbo、Aesthetic 這種本來就穩的版本不錯;euler_a(Euler Ancestral)帶隨機性,畫面更有靈氣,但同一種子每次結果略有不同;dpmpp_2m_sde_gpu 收斂快、品質高。具體選哪個,對比 30 步下的出圖即可。
隨機種子決定初始噪聲圖的「隨機序列號」。同一種子加完全相同的參數,出的圖就完全一致,可復現。固定種子的用處在於:調出一個不錯的構圖後,想微調提示詞或參數時,鎖住種子就能控制變數、方便對比。隨機種子(-1)則每次都從不同噪聲起步,結果各不相同。演示時用同一提示詞、同一參數、不同種子(1、2、3)各出一張,能明顯看出構圖和細節的差異。
LoRA 一句話說是個輕量的「附加模組」,能給底模加畫風、角色或概念,不用重訓整個大模型。用法也簡單:把 .safetensors 格式的 LoRA 放進 ComfyUI/models/loras/,工作流里加一個「Load LoRA」節點,接到擴散模型和取樣器之間,再調 LoRA 權重(一般 0.6–1.2,太大畫面會崩)。本章只講怎麼用現成的 LoRA,不涉及訓練方法。
章節說明:Anima 的訓練資料融合了 Danbooru 風格標籤和自然語言描述,所以提示詞既有標籤的規則,又有句子的靈活。本章系統講這兩種寫法。
簡單交代下背景:Anima 的訓練集裡有幾百萬張動漫圖和約 80 萬張非動漫藝術圖,動漫知識截止到 2025 年 9 月。每張動漫圖都配了 Danbooru 社群風格的標籤(如 1girl、blue_hair)和人工寫的自然語言描述,所以它既聽得懂標籤,也聽得懂句子,還能混著用。另外還混了兩個非動漫資料集 LAION-POP 和 DeviantArt,用「資料集標籤」區分。
標籤用小寫英文字母,之間用英文逗號加空格隔開(, );多詞標籤用空格不用下劃線,比如 school uniform 而不是 school_uniform,唯一的例外是 score 標籤(score_9 這類)用下劃線。示例:1girl, white hair, blue eyes, school uniform, sitting, coffee shop。順序上官方建議按「品質/元資訊 → 主體(1girl 等)→ 角色 → 系列 → 畫師 → 通用標籤」的大致順序排,段內順序隨意。
Anima 的訓練資料裡有兩套品質評價,寫的時候可以二選一,也可以混用。人工評級標籤從高到低:masterpiece(傑作)、best quality(最佳品質)、good quality(良好品質)、normal quality(普通品質)、low quality(低品質)、worst quality(最差品質)。PonyV7 美學模型評分標籤從高到低:score_9、score_8、score_7……score_1。官方推薦的正向字首是 masterpiece, best quality, score_7, safe(實際使用時結尾帶上英文逗號再接其他標籤),負向開頭寫 worst quality, low quality, score_1, score_2, score_3。正負向都寫品質標籤,是因為一個告訴模型要什麼品質,一個告訴它排除什麼品質,兩頭一夾更穩。
Anima 支援用特定格式呼叫訓練資料裡出現過的畫師風格:提示詞里加 @畫師名,比如 @wanwan。注意這個 @ 必須加,不加效果會弱很多;加權重 (@wanwan:1.2) 則增強這個畫風的影響。畫師標籤靈不靈,取決於訓練資料裡該畫師的作品多不多,不是每個名字都有效。
畫師名可以是帶空格的多個詞,官方模型卡的示例提示詞裡就有 @nnn yryr 這樣的實際用例。想驗證某個畫師標籤靈不靈,最快的辦法是鎖住種子,分別生成「帶 @畫師名」和「不帶」的兩張圖對比。另外畫師標籤的位置很自由,放在自然語言描述的開頭也有效,比如 masterpiece, best quality, @畫師名. An anime girl with...。如果想要的畫風在畫師標籤裡實在找不到,還有個退路:去 CivitAI 等社群找現成的 Anima 風格 LoRA,官方就給過一個附帶資料集和訓練配置的風格 LoRA 示例(https://civitai.com/models/2536147),照著它也能自己訓一個。
除了標籤,Anima 也聽得懂完整英文句子,建議正向提示詞裡至少放 2–3 句完整描述。推薦的寫法是按從全域性到局部的順序分層:先寫全域性品質標籤,再寫主體(角色是誰、長什麼樣、穿什麼、在幹什麼),接著寫環境和細節(什麼場景、背景有什麼、光線如何),最後寫氛圍情緒(溫暖、清冷、夢幻還是緊張)。套用第六章的提示詞,擴成句子就是這樣:
masterpiece, best quality, score_7, safe, 1girl, white hair, blue eyes, school uniform, sitting at a wooden table in a cozy cafe, holding a cup of latte, afternoon sunlight streaming through the window, warm and relaxing atmosphere
同一個主題,可以對比純標籤、純句子、混著寫三種寫法的出圖差異。
想強調或弱化某個元素,可以用權重語法 (關鍵詞:權重):大於 1 是增強,小於 1 是減弱。比如 (white hair:1.3) 逼模型出白髮,(coffee:0.8) 讓咖啡別太搶眼。有一點要注意,Anima 對權重的敏感度比 SDXL 低,得給更大的值才到同等效果,官方示例甚至用 (chibi:2),所以權重可以放心往大試,不必照 SDXL 的習慣停在 1.5。
拿「一個女孩在花園裡」這個主題,看提示詞怎麼一步步進化:
a girl in a garden → 畫面空泛,缺細節,品質一般。masterpiece, best quality, score_7, safe, a girl in a garden → 畫質提升,但內容還是籠統。masterpiece, best quality, 1girl, white dress, long brown hair, standing in a rose garden, holding a bouquet, soft sunlight, pink flowers → 畫面具體化,元素豐富。masterpiece, best quality, 1girl, white dress, long brown hair, standing in a rose garden, holding a bouquet, (sunlight:1.2), pink flowers, soft bokeh background, dreamy atmosphere → 最終版畫面精緻、氛圍到位。每步配一張對應生成圖,一眼就能看出「提示詞越具體,畫面越好」。
除了品質和畫師,Anima 還認幾類標籤。時間標籤:具體年份用 year 2025、year 2024 這種,也可以按畫風新舊用 newest、recent、mid、early、old。安全標籤:safe、sensitive、nsfw、explicit,用來控制內容尺度,官方推薦的正向字首裡就帶了 safe,想避免意外內容就把它加進正向。資料集標籤:模型額外用 LAION-POP 和 DeviantArt 兩個非動漫資料集訓練過,這類資料的描述開頭會帶一個數據集標籤(ye-pop 或 deviantart)加換行,普通使用者一般用不到,知道有這麼回事就行。
本部分目標:面向想深入理解 Anima 原理的讀者,用通俗但嚴謹的語言逐模組拆解。術語首次出現都給「人話」解釋,不堆公式,但技術細節保持準確。
章節說明:以一張完整資料流圖為核心,讓讀者先看到全景,後續章節再逐塊深入。
從「輸入提示詞」到「輸出圖片」的完整流程,標出所有關鍵模組和資料形狀:
使用者提示詞(文字)
  → Qwen3 分詞器 + T5 分詞器(雙路輸入)
  → Qwen3-0.6B 文字編碼器(輸出語義向量 512×1024)
  → LLM Adapter(6層Transformer橋,融合T5骨架,輸出 crossattn_emb 512×1024)
  → 隨機噪聲(潛空間 16×128×128)+ 噪聲時間步 t
  → DiT 主幹(28層Transformer,逐層注入crossattn_emb,預測速度場 v)
  → 多次迭代去噪(Rectified Flow 取樣器)
  → VAE 解碼器(把 16×128×128 解壓回 3×1024×1024 RGB圖片)
  → 最終生成的圖片
流程圖裡用不同顏色標出「訓練時固定的部分」(如 Qwen3)和「推理時動態變化的部分」(如噪聲)。
| 模組 | 一句話職責 |
|---|---|
| Qwen3-0.6B 文字編碼器 | 把文字提示詞翻譯成語義向量(凍結,不參與訓練) |
| LLM Adapter | 把 Qwen3 的語義「橋接」到擴散模型能相容的空間(6層Transformer) |
| DiT 主幹 | 核心生成網路,在潛空間完成去噪(28層,約2.1B參數) |
| VAE | 壓縮/解壓圖像,讓擴散模型在低維空間高效操作(16通道,8×壓縮) |
| Rectified Flow 取樣器 | 控制去噪路徑和步長,決定最終輸出品質 |
章節說明:詳細拆解「提示詞是怎麼被模型理解的」這條上游鏈路。
SDXL 這類傳統模型用 CLIP 做文字編碼器,上下文視窗只有 77 個 token,也就是大概只能看 77 個英文單詞,長提示詞會被截斷,資訊丟得厲害。Anima 改用 Qwen3-0.6B,一個真正的現代大語言模型,上下文視窗 512 token,能完整讀複雜的、結構化的長句。差別在哪?寫「一個穿白連衣裙、戴紅圍巾、站在花園裡、手拿一束粉玫瑰、陽光從樹葉間灑下來的女孩」,CLIP 可能只抓到「女孩」「花園」「玫瑰」,Qwen3 能理清所有細節之間的關係。
Anima 訓練時,Qwen3-0.6B 的參數是凍結的,也就是訓練過程不更新它的權重。原因是 Qwen3 早在大規模文字語料上預訓練好了,語義理解夠強,凍結它既省訓練視訊記憶體,又防止模型把學到的語言知識「忘掉」。所以實際訓練只更新 DiT 主幹和 LLM Adapter 的少量參數。
先說動機。Anima 的基礎架構 Cosmos-Predict2 當初是為 T5 文字編碼器最佳化的,cross-attention 層期望輸入 1024 維的 T5 風格向量。Qwen3 輸出的維度剛好也是 1024,維數對得上,但語義分佈和 T5 不一樣,直接塞進去效果差。於是中間插了一個可訓練的 6 層 Transformer「橋」,叫 LLM Adapter。它的做法是:拿 T5 分詞器生成的 token 序列(512 個 token id)當「骨架」,拿 Qwen3 的輸出當「語義來源」,用交叉注意力把 Qwen3 的語義逐 token 寫進 T5 骨架,最後輸出 DiT 要的 512×1024 條件向量。打個比方,Qwen3 是會外語的翻譯官,Adapter 是口譯員,把外語翻成 DiT 聽得懂的本地話。
Anima 的文字編碼管線同時用兩個分詞器:Qwen3 分詞器把提示詞切成 Qwen3 能懂的 token,送進 Qwen3 拿語義嵌入;T5 分詞器把同一段提示詞切成 T5 格式的 token,作為 Adapter 的骨架輸入。要兩個分詞器的原因是,Adapter 需要 T5 骨架當「槽位」,語義內容從 Qwen3 填進來,這是工程上的橋接做法,不是設計冗餘。訓練時兩個分詞器都不更新,只有 Adapter 學怎麼把 Qwen3 的語義映射到 T5 骨架裡。
章節說明:本章深入 Anima 最核心的生成網路,解釋「Transformer 怎麼用來畫畫」。
直接處理畫素很難。一張 1024×1024 的圖有 300 多萬個值,Transformer 自注意力的複雜度是 O(n²),啃不動這麼大的序列。解決辦法(和 VAE 壓縮還不一樣)是 PatchEmbed:把潛空間特徵(16×128×128)按 2×2 的空間塊切,每塊 16×2×2=64 個值,展平後過一層線性投影到 2048 維(實現裡還會拼上少量填充通道,投影輸入實際是 68 維)。結果 128×128 的潛空間被切成 (128/2)×(128/2)=4096 個 patch,每個 patch 變成一個 2048 維的 token,DiT 處理的就是這 4096 個 token 的序列。可以把這想像成把一幅畫切成 4096 塊拼圖,每塊裝進一個資訊包,Transformer 負責處理這些資訊包之間的關係。
每個 Transformer Block 有三個按順序執行的子層。自注意力讓 4096 個 token 互相「看」,捕捉畫面裡不同位置的空間關係,比如頭髮和肩膀的位置關係;交叉注意力讓這 4096 個 token 去「看」來自 Adapter 的 512 個文字 token,把提示詞的語義灌進生成過程;前饋網路(MLP)對每個 token 獨立做非線性變換,增強表示能力,類似 Transformer 的 FFN,GPT-2 風格、GELU 啟用。三個子層都帶殘差連線和 AdaLN 條件調變(見 11.4)。base 版有 28 層 Block,每層結構一樣、參數獨立。
Transformer 本身是順序無關的,它不知道 token 在畫面哪個位置,得額外塞位置資訊。Anima 用 3D RoPE(旋轉位置編碼),沿高、寬、時間三個維度分別編碼位置。時間維在 Anima 裡主要用於圖像(T=1),但架構保留了影片擴充套件能力;高和寬兩個維度各配獨立旋轉頻率。另外 Anima 給 h/w 軸設了 4.0 倍的 NTK 外推倍率:訓練時見到的最大解析度是 1024²(對應 128×128 潛空間),推理時靠 RoPE 的 NTK 縮放,能外推到 1536² 甚至更高而不嚴重失真。位置編碼好比給每塊拼圖貼上「第幾行第幾列」的標籤,NTK 外推讓這些標籤在畫面放大後依然定位得準。
擴散模型得知道「現在是去噪第幾步」(時間步 t),才能決定去噪的強度和策略。Anima 的做法是,每個 Block 的三個子層前都放一個 AdaLN(自適應層歸一化)調變模組,時間步 t 被編碼成向量,過一個小網路生成 shift(偏移)、scale(縮放)、gate(門控)三個參數,作用在層歸一化後的特徵上。AdaLN-LoRA 特別在用了低秩設計,把調變參數壓到 256 維低秩空間再投回來,既省參數又不失靈活。效果就是,時間步 t 靠這套機制告訴模型「現在還早,先畫輪廓」或「到後期了,該補細節」。
Transformer 訓練常有個毛病:注意力分數(Q 和 K 的點積)可能過大,導致梯度不穩。Anima 的解法是,算點積前分別對 Q、K 做 RMSNorm(均方根歸一化),把模長控制在穩定範圍。這是近幾年 LLM 和 DiT 裡驗證有效的穩定化手段,讓 Anima 大規模訓練時更穩。
把官方權重檔案(safetensors)直接拆開數了一遍:DiT 主幹共 2,091,068,928 個參數,約 2.09B,和官方「2B」的口徑一致。其中 28 個 Transformer Block 每層約 6,920 萬參數,合計約 1.94B;剩下的約 1.5 億參數是 PatchEmbed、時間步嵌入、Final Layer、T5 詞表嵌入和 LLM Adapter 這些外圍模組。把 Qwen3(5.96 億)和 VAE(1.27 億)也加進來,三個檔案合計約 2.8B。作為參照,SDXL 的 U-Net 約 2.6B,兩者量級相近,但架構完全不同。
章節說明:解釋 VAE 的壓縮/解壓作用,以及 16 通道設計的技術含義。
VAE(變分自編碼器)分編碼器和解碼器兩塊:編碼器把輸入圖(3 通道 RGB,1024×1024)壓成更小的潛在表示(16 通道,128×128),解碼器再把潛在表示還原回畫素空間。壓縮倍率上,空間 8× 下采樣(1024→128)、通道從 3 增到 16,總資訊量大減,擴散模型才能在潛空間高效操作。有一點別誤會,VAE 自己不「生成」新內容,它只是個還原度很高的編解碼工具,壓縮本身有損,只是肉眼基本看不出來。
Qwen-Image VAE 的具體規格:
| 項 | 值 |
|---|---|
| 基礎通道數 | 96 |
| 通道倍增配置 | [1, 2, 4, 4],即各層輸出通道為 96、192、384、384 |
| 殘差塊數 | 每層 2 個 |
| 注意力模組 | 無(attn_scales=[]),是純卷積 VAE |
| 潛在空間通道數 | 16(z_dim=16) |
| 時間維下采樣 | 支援影片但圖像場景 T=1 不受影響 |
潛在空間的每個通道都有獨立的均值(mean)和標準差(std),用於歸一化和反歸一化。
SDXL 的 VAE 是 4 通道,Anima 是 16 通道。16 通道意味著每個空間位置裝的資訊更豐富,DiT 首層投影的輸入維度是 16×2×2=64(patch 2×2),末層反投影是 64→16。設計取向也不同:Anima 的 VAE 不含注意力層(attn_scales=[]),長程依賴全交給 DiT;SDXL 的 VAE 帶注意力層,自身就有一點全域性建模能力。這是兩種架構的取捨,沒有誰更好。Anima 的 DiT 已經扛了全域性注意力,VAE 專心做壓縮,分工更清楚。
章節說明:解釋 Anima 的預測目標和生成框架跟傳統 DDPM 有何不同,以及這種不同對 CFG、步數這些使用體驗的實際影響。
擴散模型裡有兩個經常被當成一回事、其實是獨立選擇的維度:預測目標和生成框架。這一節先講預測目標,生成框架放到 13.3。
預測目標,說的是模型訓練時到底迴歸什麼。主流兩種。ε-prediction 預測加進去的噪聲,給一張加了噪的圖讓模型猜裡面混了多少噪聲,取樣時再減掉;v-prediction 預測速度場 v(v = α·ε − σ·x₀),給目前狀態直接預測「往乾淨圖方向該走多快、朝哪走」。
一個容易被搞反的先後關係:v-prediction 不是 Rectified Flow 帶來的。它最早是 Salimans & Ho 在 2022 年 2 月的《Progressive Distillation》裡、在 DDPM 離散框架內部提出的,本意是讓蒸餾和 zero-SNR 訓練時數值更穩;Rectified Flow 是同年 9 月才出現的另一個框架,只是它天然用速度場當訓練目標。準確說是「Rectified Flow 沿用了更早的 v-prediction」,反過來講就錯了。
因為兩個維度正交,DDPM 框架裡既能預測 ε 也能預測 v。NoobAI-XL V-Pred 就是留在 DDPM 框架、只把目標從 ε 換成 v 的例子,還配了 zero-SNR 排程。ε-prediction 像在霧裡找回家的路,每一步都在猜霧有多濃;v-prediction 像手裡攥著一張直達地圖,往哪走、走多遠,抬手就能看到。總體上 v-prediction 數值更穩、取樣路徑更直接。
CFG(分類器自由引導)是在條件生成和無條件生成之間放大差值,來增強提示詞的影響。ε-prediction 下,無條件和有條件預測的差異不大,得用高 CFG(7–9)才夠引導強度,但太高容易過飽和、對比失真;v-prediction 下,速度場方向更明確,兩種預測的差異天然更大,CFG 只要 4–5 就夠,還不容易過飽和。這是預測目標帶來的特性,不是 Anima 的「調校偏好」。
接著 13.1 說第二個維度,生成框架,也就是時間軸怎麼走。傳統 DDPM 把去噪離散成 1000 個整數步(t=0, 1, 2, …, 999),模型只在這 1000 個點上學習。Rectified Flow 用連續時間域 t ∈ [0, 1],時間步可以取任意實數,模型靠學連續時間上的速度場來泛化到任意步長。好處是推理時想用幾步就幾步(10、20、30、50 都行),不用被訓練時的離散步數綁住,步數越少越快,品質下降也平緩。
訓練時,時間步 t 的取樣分佈會影響模型在不同噪聲強度下的表現。Anima 支援多種取樣策略(uniform、sigmoid、shift、flux_shift),其中 anima_shift 是專門為解析度自適應設計的。原理是,高解析度圖細節多,需要把更多「去噪預算」壓在高噪聲段,所以 anima_shift 會按目前訓練圖的解析度動態調時間步取樣分佈:1024²(基準)時 α=1.0、偏移 0、分佈不變;解析度更高(如 1536²)時 α>1.0,取樣分佈往高時間步偏,模型在高噪聲段練得更多。這樣一來,Anima 能同時在多種解析度上訓練和推理,跨解析度遷移也更好。
章節說明:用一張大表和逐項討論,客觀呈現 Anima 與 SDXL 的異同。
| 維度 | Anima(Anima-base) | SDXL |
|---|---|---|
| 主幹類型 | DiT(純 Transformer) | U-Net(CNN + 注意力) |
| 主幹參數量 | ≈ 2.09B(28 層 × 2048 維) | ≈ 2.6B(U-Net) |
| 主幹處理方式 | 4096 tokens @ 1024²(patch 2×2) | 64×64×4 = 16384 潛空間特徵 @ 1024² |
| 生成框架 | Rectified Flow(v-prediction) | DDPM(ε-prediction) |
| 時間域 | 連續 [0, 1] | 離散 1000 步 |
| 噪聲排程 | 線性插值(流匹配) | 固定 β 排程 |
| 文字編碼器 | Qwen3-0.6B(單編碼器) | OpenCLIP ViT-bigG + ViT-L(雙編碼器) |
| 文字 token 數 | 512(Qwen3)+ 512(T5 骨架) | 77 + 77 = 154 |
| 文字注入方式 | Adapter 橋 → cross-attn(每 block) | 雙編碼器輸出 concat → cross-attn + pooled → adaGN |
| 文字橋模組 | 6 層 Transformer(≈134M) | 無 |
| 潛在通道 | 16 通道,8× 壓縮 | 4 通道,8× 壓縮 |
| VAE 類型 | Qwen-Image VAE(純卷積,無注意力) | SDXL KL-VAE(含注意力) |
| 位置編碼 | 3D RoPE + NTK 外推(h/w 4.0×) | 無(卷積平移不變) |
| 注意力歸一化 | QK-Norm(RMSNorm)+ RoPE(僅 self) | 標準 MHA,無 QK-norm |
| 條件調變 | AdaLN-LoRA(shift/scale/gate,256維低秩) | adaGN(時間嵌入 shift/scale) |
| 歸一化方式 | LayerNorm(無 affine)+ RMSNorm | GroupNorm |
| 推薦取樣器 | Euler / dpmpp_2m_sde_gpu | DDIM / DPM++ |
| 推薦步數 | 30–50 | 30–50 |
| 推薦 CFG | 4–5 | 7–9 |
| 原生解析度 | 512²–1536²(H/W 需被 16 整除) | 1024²(H/W 需被 64 整除) |
| 解析度外推 | RoPE NTK 外推(顯式機制) | U-Net 天然任意解析度但品質隨尺寸下降 |
| 生態成熟度 | 較新,生態成長中 | 成熟,全網最完整生態 |
Anima 這邊:文字理解上限高,Qwen3 的 512 token 能精確讀複雜指令和長句,比 SDXL 雙 CLIP 的 77×2 強太多;低 CFG 穩定,4–5 就有好引導,色彩對比更自然;步數彈性好,連續時間訓練支援任意步數,Euler 30 步就有高品質;顯式解析度外推,RoPE + NTK + anima_shift 是一套可解釋、可調的解析度自適應機制;架構現代,純 Transformer 方便複用 LLM 社群的最佳化工具。
SDXL 那邊:生態成熟度碾壓,ControlNet 全家桶、IP-Adapter、AnimateDiff、海量外掛和工作流,社群資源最全;可控生成工具鏈完整,姿態、深度、線稿各類控制條件都有成熟實現;U-Net 卷積先驗在多尺度特徵上有天然的多解析度感受野,極高解析度(如 2048²)的擴充套件推理成本比 DiT 全域性自注意力低;長期驗證穩定,2023 年發布至今被海量使用者踩過坑,訓練推理的坑基本都填平了。
Anima 這邊:自注意力是二次方成本,4096 token 的全域性注意力在高解析度下 token 數暴漲(2048² 就是 16384 tokens),視訊記憶體和算力開銷大,靠 RoPE 外推而不是直接高解析度訓練;生態年輕,可控生成目前主要是 ControlNet-LLLite,覆蓋遠不如 SDXL;雙分詞器加 Adapter 多了層複雜度,LLM Adapter 依賴 T5 骨架,如果 T5 分詞和目標提示詞語義有偏差會引入損耗;資訊瓶頸上,16 通道 VAE 加純卷積設計,VAE 自己不建模長程依賴,全域性關係全壓給 DiT。
SDXL 那邊:文字理解受限,CLIP 77 token 處理長提示詞會截斷、丟細節;高 CFG 副作用,7–9 容易過飽和、色彩溢位,得靠負向提示詞和取樣器技巧去調;解析度外推沒保障,U-Net 雖能跑任意解析度,但高解析度下易出重複紋理、結構崩塌,得靠外部高清修復流程兜底;架構接近壽命末端,U-Net + DDPM 已非目前 SOTA 方向,社群和廠商的追蹤在往 DiT、流匹配遷移。
| 術語 | 人話解釋 |
|---|---|
| DiT | Diffusion Transformer,用 Transformer 做擴散生成的主幹網路 |
| VAE | 變分自編碼器,負責圖像的壓縮和解壓 |
| RoPE | 旋轉位置編碼,給 Transformer 的 token 注入位置資訊的一種方式 |
| NTK 外推 | 一種縮放旋轉頻率、讓模型支援更高解析度的技術 |
| CFG | 分類器自由引導,控制提示詞影響力的參數 |
| Rectified Flow | 一種生成框架,訓練目標為預測速度場(v-prediction) |
| v-prediction | 速度場預測,直接預測「噪聲→乾淨圖」的移動方向 |
| ε-prediction | 噪聲預測,傳統擴散模型預測「混入了多少噪聲」 |
| DDPM | 去噪擴散機率模型,傳統擴散模型的數學框架 |
| U-Net | 一種帶跳躍連線的卷積網路,SDXL 的主幹架構 |
| Transformer | 基於自注意力的神經網路架構,LLM 的核心元件 |
| Attention / 自注意力 | 讓 token 之間互相「看」、捕捉相互關係的機制 |
| Cross-Attention / 交叉注意力 | 讓圖像 token「看」文字向量、注入語義的機制 |
| AdaLN | 自適應層歸一化,用時間步調變每一層特徵 |
| AdaLN-LoRA | 低秩版 AdaLN,把調變參數壓縮到低秩空間 |
| QK-Norm | 對注意力裡的 Q 和 K 做歸一化,穩定訓練 |
| RMSNorm | 均方根歸一化,一種輕量的歸一化方法 |
| LayerNorm | 層歸一化,另一種常見的歸一化方法 |
| PatchEmbed | 把潛空間切成小塊並投影成 token 的模組 |
| Tokenizer / 分詞器 | 把文字切成 token 序列的工具 |
| Token | 文字或圖像被切分後的最小處理單元 |
| Text Encoder / 文字編碼器 | 把提示詞翻譯成向量的模型(Anima 用 Qwen3) |
| LLM Adapter | 把 Qwen3 語義橋接到 T5 相容空間的 6 層橋 |
| Latent / 潛空間 | VAE 壓縮後的低維特徵空間 |
| Sampler / 取樣器 | 控制去噪「行走路徑」的演算法 |
| Scheduler / 排程器 | 控制噪聲隨時間衰減方式的模組 |
| Steps / 步數 | 去噪過程的迭代次數 |
| Seed / 種子 | 決定初始噪聲的隨機序列號,用於復現 |
| LoRA | 輕量附加模組,給底模增加畫風/角色/概念 |
| Hugging Face | 模型權重託管平台 |
| ComfyUI | 節點式 AI 繪畫圖形介面 |
| safetensors | 一種安全的模型權重檔案格式 |
| Rectified Flow 取樣器 | Anima 的取樣排程器,連續時間 [0,1] |
Q1:為什麼生成結果和別人不一樣?
A:生成結果由「提示詞 + 參數 + 隨機種子」共同決定。只要種子不同(預設 -1 隨機),或任何參數、提示詞有細微差異,結果就會不同。想復現某張圖,需要完全相同的提示詞、參數和種子。
Q2:Anima 能不能生成寫實風格?
A:Anima 的訓練資料以動漫/二次元風格為主,強項在動漫風格。靠提示詞硬調也能出幾張,但一般不如專門的寫實模型,想寫實建議直接換模型。
Q3:視訊記憶體不足怎麼辦?
A:按優先順序嘗試:① 降低解析度(1024→768→512);② 降低批大小;③ 啟動 ComfyUI 時加 --lowvram 或 --novram;④ 關閉其他佔用視訊記憶體的程式。
Q4:生成速度太慢怎麼辦?
A:① 減少採樣步數(50→30);② 換用 dpmpp_2m_sde_gpu 或 euler;③ 降低解析度;④ 確認顯示卡驅動為最新版。
Q5:提示詞寫中文可以嗎?
A:Anima 主要針對英文提示詞訓練,建議寫英文。中文可以寫,但理解和生成品質通常不如英文。可以用翻譯工具先把中文需求譯成英文。
Q6:報錯「CUDA is not available」怎麼辦?
A:顯示卡驅動未安裝或版本過低,去 NVIDIA 官網更新驅動後重試。
Q7:報錯「CUDA out of memory」怎麼辦?
A:見 Q3,本質是視訊記憶體不夠。
Q8:報錯「Checkpoint file not found」怎麼辦?
A:模型檔案路徑不正確,回看第四章,確認 DiT 放在 models/diffusion_models/ 下且檔名一致。
Q9:報錯「Node type not found」怎麼辦?
A:工作流使用了未安裝的自訂節點,去 ComfyUI Manager 安裝對應缺失節點。
Q10:生成結果全黑或全灰怎麼辦?
A:大機率是 VAE 載入失敗或連線錯誤,檢查 VAE 節點是否連線正確、VAE 檔案是否完整。
Q11:CFG 應該設多少?
A:Anima 推薦 4–5,遠低於 SDXL 的 7–9。不要按 SDXL 的習慣去設。
Q12:取樣步數設多少合適?
A:30–50 步價效比最高,超過 80 步基本無肉眼可見提升。
Q13:解析度必須 1024×1024 嗎?
A:不必。1024² 是原生訓練解析度、效果最穩。可以用其他尺寸,但 H 和 W 都必須能被 16 整除(VAE 8× 下采樣 × DiT 2×2 patch = 16)。
Q14:可以用非正方形解析度嗎?
A:可以,如 1024×1536,只要兩邊都能被 16 整除即可。
Q15:正向和負向提示詞都要寫品質標籤嗎?
A:推薦都寫。正向寫 masterpiece, best quality,負向寫 worst quality, low quality,雙管齊下更穩定。
Q16:標籤式提示詞和句子式提示詞哪個好?
A:Anima 兩種都理解,且可混用。推薦「品質標籤 + 主體標籤 + 2–3 句自然語言描述」的混合寫法。
Q17:權重語法 (word:1.3) 裡的數字範圍多少合適?
A:有效範圍通常 0.5–1.5。Anima 對權重敏感度略低於 SDXL,從 1.2 開始試,必要時到 1.5。
Q18:LoRA 權重設多少?
A:通常 0.6–1.2 之間,太大會導致畫面崩壞。
Q19:模型檔案要下載幾個?
A:三個:DiT 主幹(~4.2GB)、文字編碼器(~1.2GB)、VAE(~0.25GB)。
Q20:可以只下載一個檔案就跑嗎?
A:不能。Anima 需要三個元件協同工作,缺一不可。
Q21:AMD 顯示卡能用嗎?
A:Anima 主要針對 NVIDIA(CUDA)最佳化,AMD 顯示卡需要額外配置,體驗可能不如 NVIDIA。
Q22:生成的時候命令列視窗能關嗎?
A:不能。那個視窗是 ComfyUI 的服務程序,關掉就等於停止服務。生成完、不再用的時候再關。
https://huggingface.co/circlestone-labs/Animahttps://github.com/comfyanonymous/ComfyUIREADME.md 內的示例圖片(拖曳匯入)https://civitai.com/models/2458426/animahttps://tensor.art/models/998619401697644790/Anima-Official-circlestone_labs-base-v1.0https://kusart.comhttps://imgnai.com/https://www.mage.space/https://aliveai.app/https://www.dreamerland.ai/全文完
 Kusa_OlxY
留言
留言暫未開放